現役組み込みエンジニアが、さくらのAI Engineでコーディング支援を試してみた ― AIは「組み込みのコード」をどこまで書けるのか

1. はじめに
私は現役の組み込みエンジニアで、普段の業務ではマイコンの組み込み開発やC言語でのコーディングに携わっています。本業ではMicrosoft CopilotやGitHub Copilotを日常的に使っており、AIによるコーディング支援はもはや当たり前の道具になりつつあります。
そんな中で、さくらインターネットが提供する「さくらのAI Engine」が、無料枠だけでもコーディング支援に使えると知りました。しかも国産のサービスです。これは試さない手はない、と思い立ったのがこの記事のきっかけです。普段からAIコーディングを使っている身として、「無料枠の国産APIだけで、組み込み向けの“自前のコーディング環境”がどこまで作れるのか」――そこは素直に気になりました。
ただ、せっかく現役の組み込みエンジニアが試すなら、「便利でした」で終わらせたくありません。この記事で検証したいのは、次の問いです。
AIは「組み込みのコード」を、どこまで書けるのか。
WebやアプリのAIコーディング事例はよく見かけますが、組み込みは少し事情が違います。その違いを、使う側=現役エンジニアの目で確かめてみました。
2. セットアップ:さくらのAI Engine × Cline
最初に、今回の構成を整理しておきます。ここが分かると、後の話がスムーズです。
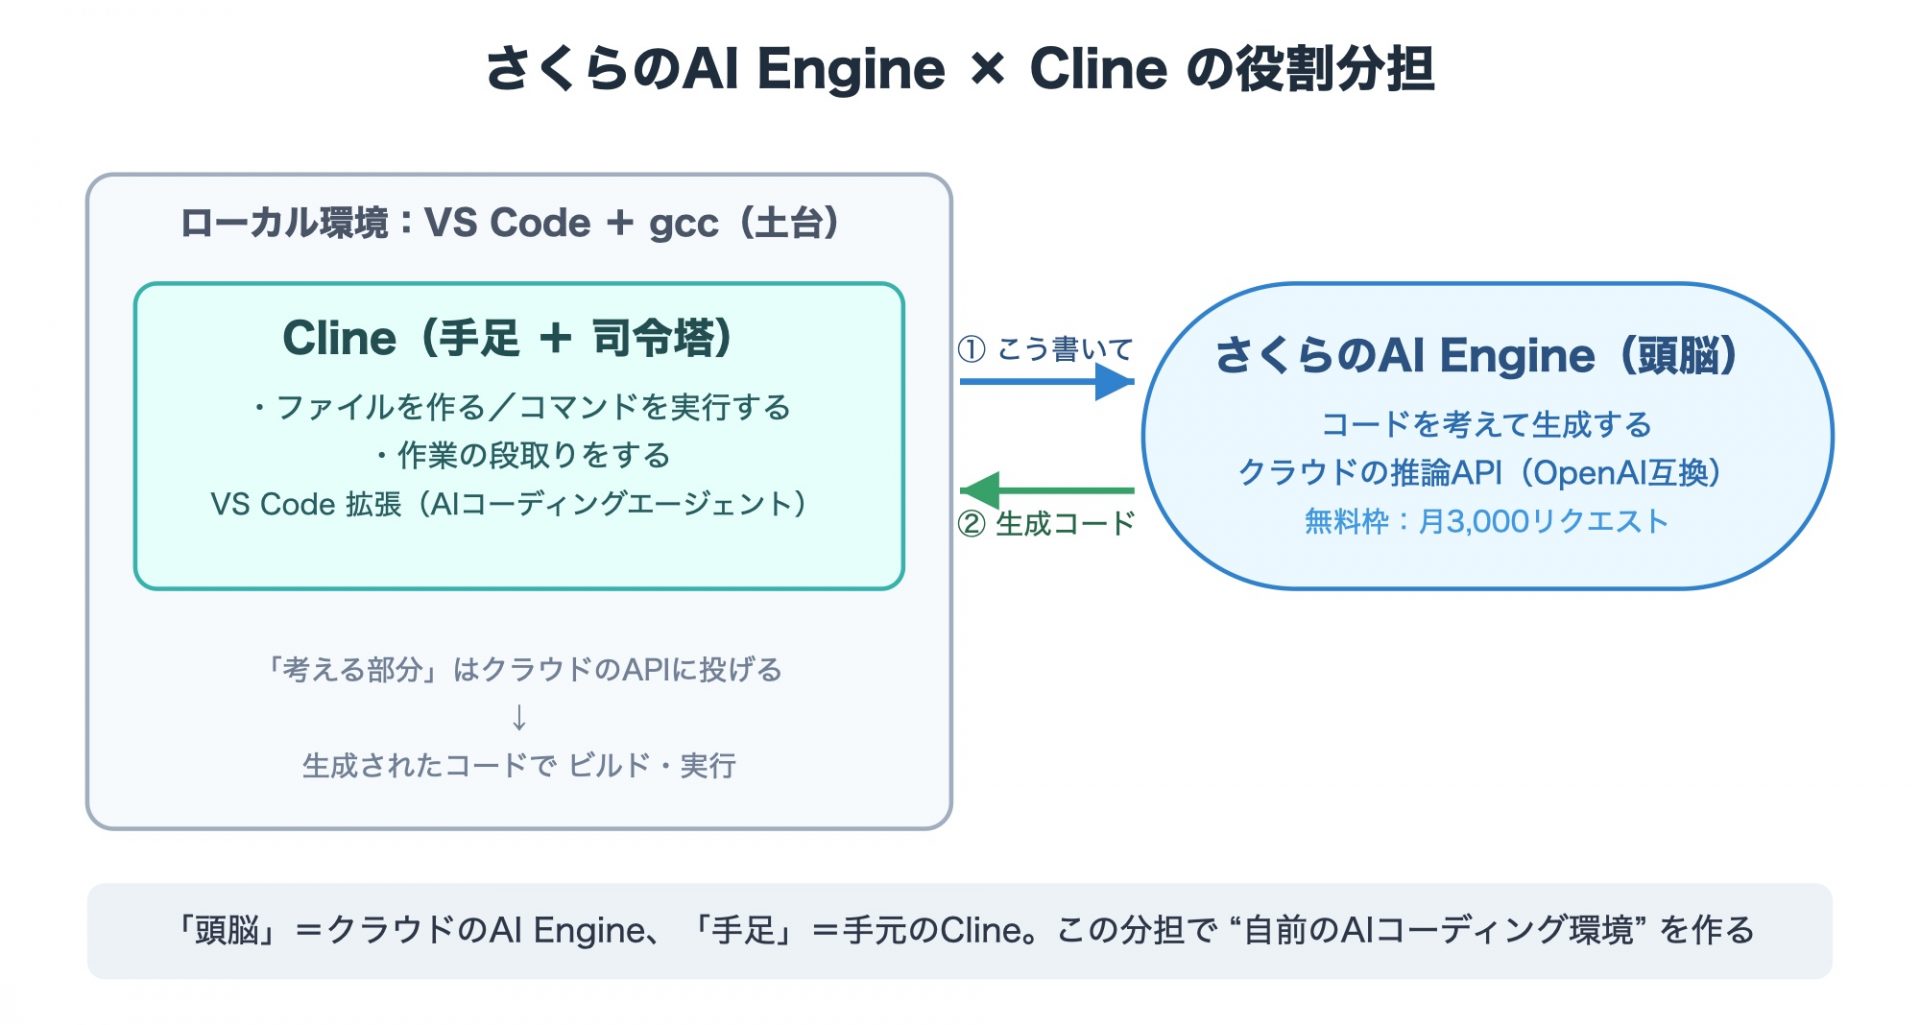
さくらのAI Engineは「推論API」です。 OpenAI/Anthropic互換のAPIで、リクエストを送ると生成結果を返してくれます。言い換えると「頭脳」の部分だけを提供するサービスで、GitHub Copilotのように“入れればすぐ使える完成品”ではありません。
そこで、この頭脳を実際のコーディング作業につなぐ「手足」が必要になります。今回はVS Codeの拡張機能で、AIコーディングエージェントの Cline を使いました。Clineが「ファイルを作る・コマンドを実行する・段取りする」役割を担い、考える部分はさくらのAI Engineに投げる、という分担です。
- さくらのAI Engine=頭脳(コードを考えて生成する/クラウドのAPI)
- Cline=手足+司令塔(ファイル操作・コマンド実行・段取り/VS Code上で動く)
- VS Code+gcc=土台(エディタとコンパイラ)
接続の要点はシンプルです。Clineの初期設定で、自分のAPIキーを使う方式(Bring Your Own Key)を選び、
- API Provider:
OpenAI Compatible - Base URL:
https://api.ai.sakura.ad.jp/v1 - モデル:
gpt-oss-120b(無料枠で使えるモデル)
を設定するだけ。無料枠は月3,000リクエストまで使えるので、試すだけならコストはかかりません。
なお、セットアップ全体の手順は、さくらの公式マニュアル「さくらのAI Engine 利用手順」にまとまっています(私も設定時に参照しました)。
私が唯一ハマったのは、アカウントトークンの貼り方でした。トークンは「ID : シークレット」の2部構成で、この全体をコロンごと貼る必要があります。前半のIDだけだと「Invalid token」で弾かれました(しかもシークレットは発行時に一度しか表示されないので要注意です)。
こうして振り返ると、正直、一発ですんなりとはいきませんでした。ただ、今の時代はつまずいてもAIに聞けばたいていのことは教えてくれるので、思ったほど苦にはなりませんでした。
3. まず普通に書かせてみる:リングバッファ
準備ができたので、まずは素直にお願いしてみます。組み込みでも定番のデータ構造、リングバッファ(循環バッファ)です。
「C言語でリングバッファを実装してください」
すると、Clineは ring_buffer.h / ring_buffer.c / main.c / Makefile までを自分で作成し、make でビルドまで通してしまいました。デモも問題なく動きます。
正直、まず「速いな」と思いました。お願いしてから成果物が一式そろうまでが一瞬で、しかもデモまで動いています。成果物だけをパッと見る分には、問題なさそうに見えました。
生成されたコードの第一印象は、「汎用的な実装としては、素直できれい」でした。構造体を不透明型で隠蔽し、要素数をcountで管理して満杯・空を判定する――教科書的で、警告(-Wall -Wextra -pedantic)もゼロで通ります。
4. 組み込みの目で見ると?
ところが、ここからが本題です。同じコードを現役の組み込みエンジニアの目で見ると、「このままでは現場で使いにくい」と感じる点がいくつも出てきます。
- 動的メモリ(malloc/free)を使っている。組み込み、特にリアルタイム性やMISRA-Cが求められる現場では、ヒープはできるだけ避けます。断片化や確保失敗の非決定性が、嫌われる理由です。定石は固定長の静的確保です。
- 割り込み安全性がない。リングバッファの最も多い用途は、割り込み(ISR)とメインループの間でデータを受け渡すことです。ところが生成コードは
countをpush/popの両方で読み書きしており、volatileもクリティカルセクションもありません。これではISRとメインが同時に触ると壊れます。 - 剰余演算(
% capacity)を使っている。非力なMCUでは除算は重い処理です。定石は、容量を2の冪に限定して& (capacity-1)のビットマスクで済ませることです。 - void*+memcpyで汎用化している。柔軟ではありますが、小さなMCUでは型を固定してオーバーヘッドを避けるのが普通で、ややオーバーエンジニアリング気味です。
言葉だけだと伝わりにくいので、実際に生成されたコードの該当箇所を見てみます(コメントはAIが生成したまま、英語で付いています)。
/* --- 生成された構造体(抜粋) --- */
struct RingBuffer {
    size_t capacity;   // max number of elements
    size_t count;      // current number of stored elements
    size_t head;       // index of next element to pop
    size_t tail;       // index of next slot to push
    size_t elem_size;  // size of each element
    void *buffer;      // contiguous storage for elements
};

/* --- 初期化(抜粋):malloc で動的確保している --- */
RingBuffer *rb = (RingBuffer *)malloc(sizeof(RingBuffer));
rb->buffer = malloc(capacity * elem_size);

/* --- 書き込み(push 関数・全文) --- */
int ring_buffer_push(RingBuffer *rb, const void *elem) {
    if (!rb || !elem) return 0;
    if (ring_buffer_is_full(rb)) {
        return 0; // cannot push, buffer full
    }
    void *dst = (char *)rb->buffer + (rb->tail * rb->elem_size);
    memcpy(dst, elem, rb->elem_size);
    rb->tail = (rb->tail + 1) % rb->capacity;
    rb->count++;
    return 1;
}
malloc による動的確保、void*+memcpy の汎用コピー、% rb->capacity の剰余演算、そしてcountの読み書き(volatileなし)――先ほど挙げた4点が、このコードにそのまま現れています。
まとめると、「正しいけれど、PC/アプリ的」。組み込みの定石とはズレています。AIが悪いというより、「組み込みの文脈」までは汲んでいない、という感覚です。
5. 実験:組み込み向けに直させる(曖昧 vs 具体)
では、こちらの指示で直せるのでしょうか。それとも無理なのでしょうか。これを確かめるために、2段階で試してみました。
実験①:曖昧に「組み込み向けに最適化して」と頼む
まずは、ざっくりとした一言だけ。結果は“2勝2敗”でした。
- ✅ malloc廃止 → 静的確保:マクロで固定長配列を持つ型を生成し、
static inline関数で実装する、組み込みらしい作りに直してきました。 - ✅ 型固定:汎用のvoid*をやめ、型付きで直接代入する形に。
- ❌ 割り込み安全性:相変わらず
countを両方で読み書き。volatileもなし。 - ❌ 2の冪マスク:剰余演算のまま。
興味深いのは、“教科書的に有名な調整”(静的確保・型固定)はやるのに、現場で本当に重要な「割り込み安全性」や「MCU性能のためのマスク」は見落とす点です。負けた2つが、まさに“深い方”でした。
実験②:具体的に要件を指定する
次に、要件を具体的に渡しました。「動的確保を使わない」「ISRとメインループを想定して割り込み安全に」「容量は2の冪でビットマスク」「要素型はuint8_t固定」――。
すると今度は、ロックフリーのSPSC(単一producer・単一consumer)設計まで正しく書いてきました。head/tailをvolatileにし、countを廃止して“1スロット空ける”古典手法で満杯・空を区別する。ビットマスクも、uint8_t固定も、きちんと反映されています。データを書いてからtailを進める、という順序も正しい。骨格は、かなり正確です。
ただ、ここでも“最後の詰め”が甘い。現役の目で見ると、こう気になります。
- 容量が2の冪かどうかを検証していない。マスクは2の冪が前提なのに、assertもありません。
- “1スロット空ける”設計なので、容量8でも実際に使えるのは7。ところが生成された
main.cは、8個入れるつもりで書かれています。 volatileはメモリバリアやアトミック性の保証ではありません。単純な単一コアMCUなら実用上は動きますが、「割り込み安全」と銘打つには、本来もう一歩の考慮が要ります。
具体的には、生成されたコードはこうなっています。骨格(volatile・ビットマスク)は正しいのに、満杯判定とmain.cの想定がかみ合っていません。
/* --- 構造体:head/tail を volatile に、mask でラップ(骨格は正しい) --- */
typedef struct {
    uint8_t *buf;            /* データ格納領域へのポインタ */
    uint32_t capacity;       /* バッファサイズ (2 の冪) */
    uint32_t mask;           /* capacity - 1 (ビットマスク) */
    volatile uint32_t head;  /* 次に pop するインデックス */
    volatile uint32_t tail;  /* 次に push するインデックス */
} RingBuffer;

/* --- 満杯判定:1スロット空ける古典手法(tail+1 が head に追いついたら満杯) --- */
static inline int ring_buffer_is_full(const RingBuffer *rb) {
    return ((rb->tail + 1U) & rb->mask) == (rb->head & rb->mask);
}

/* --- だが生成された main.c は、容量8に8個入れるつもりで書かれている --- */
/* バッファサイズは 2 の冪 (8) とする */
static uint8_t static_buf[8];

/* 0〜7 をプッシュ */
for (uint8_t i = 0; i < 8; ++i) {
    if (ring_buffer_push(&rb, i)) {
        printf("Pushed %u\n", i);
    } else {
        printf("Push failed at %u (full)\n", i);
    }
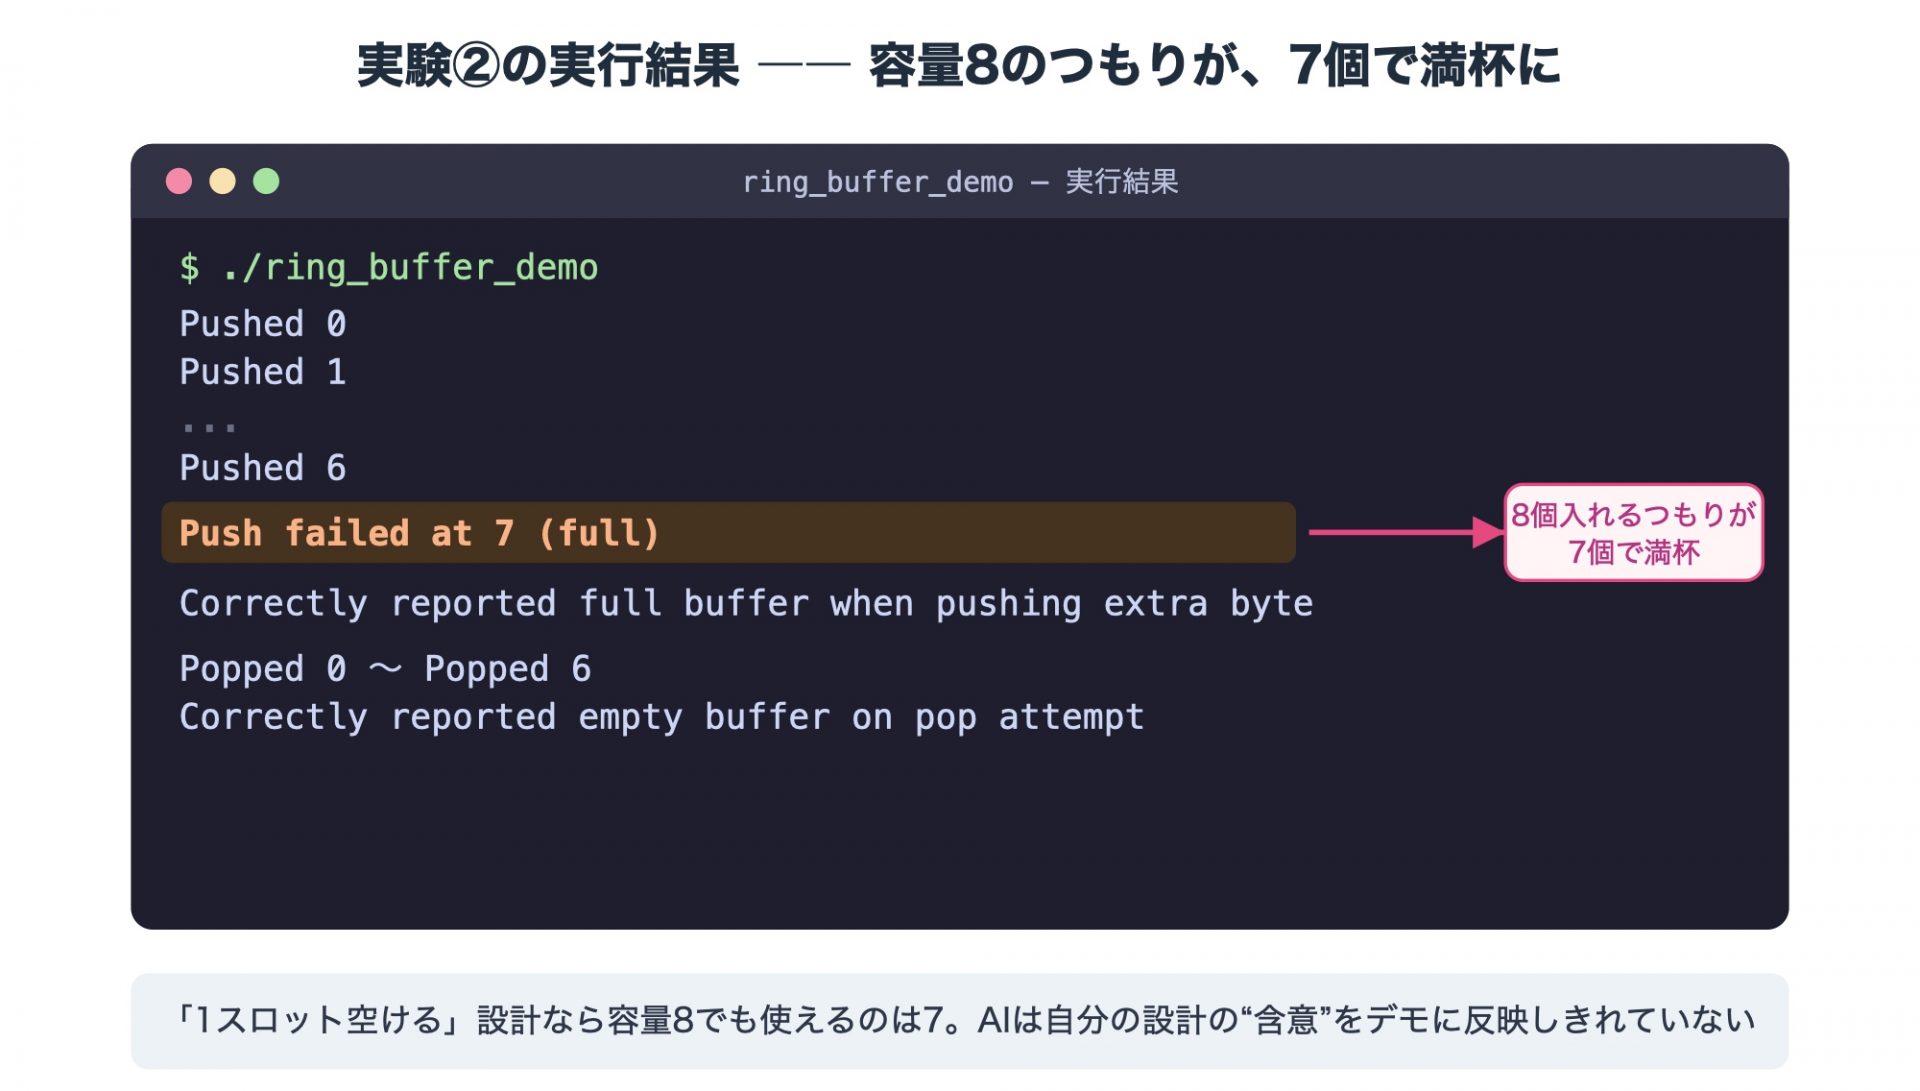
}“1スロット空ける”設計では、容量8のうち実際に使えるのは7です。ところが同じAIが書いたmain.cは、そこへ8個を入れにいく。実際、この②のコードをビルドして動かすと、こうなりました。
Pushed 0
Pushed 1
...
Pushed 6
Push failed at 7 (full)      ← 8個入れるつもりが、7個で満杯
Correctly reported full buffer when pushing extra byte
Popped 0 ~ Popped 6
Correctly reported empty buffer on pop attempt8個入れる気で書かれたデモが、7個で満杯になる。AIが、自分で選んだ設計の“含意”を、自分のデモに反映しきれていない瞬間です。
この実験で印象に残ったことが、二つあります。
一つは、実験①――曖昧に「組み込み向けに最適化して」と頼んだだけなのに、AIがある程度は自分で考えて、静的確保や型固定といった“組み込みらしい”実装に寄せてきたこと。これには、正直ちょっと感動しました。
もう一つは、実験②の「Push failed at 7」を見た瞬間です。自分でロックフリー設計を選び、「1スロット空ける」手法まで正しく書いておきながら、その含意――容量8なら本当に使えるのは7――を、自分のデモには反映しきれていない。賢いのに、どこか詰めが抜けている。その“らしさ”が、妙に印象に残りました。
6. わかったこと
2つの実験から、はっきり見えたことがあります。
AIは「一般的に正しいコード」は、ちゃんと書きます。「組み込み向けに」と曖昧に言えば、静的確保や型固定といった“有名な調整”もやってくれる。しかし、割り込み安全性やMCU性能の勘所は、こちらが具体的に要求して初めて埋まります。そして具体的に指示して骨格が正しく書けても、前提の検証・設計の含意・アーキテクチャ依存の注意といった“最後の詰め”は、分かっている人間が点検しないと漏れます。
つまり、AIコーディングの価値は「書く」から「何を要求し、どこを点検するかを判断する」へと移りつつある、ということです。組み込みのように“前提”が多い領域ほど、それを知っている現役エンジニアの目が効く――今回の検証は、私にとってそれを再確認する機会になりました。
さくらのAI Engineそのものの所感も、少し触れておきます。無料枠だけで手軽に始められ、OpenAI互換なのでClineのようなエージェントと自由に組み合わせられるのは、大きな魅力でした。国産で安心して試せる点も含めて、「自前のAIコーディング環境」を作る入口として十分に実用的だと感じます。今回は汎用モデルのgpt-oss-120bで試しましたが、コーディング特化の Kimi-K2.7-Code という選択肢もあるので、次はそちらでも試してみたいところです。
自前のAIコーディング環境は、無料枠でも作れる時代です。あとは、それを使いこなす“要求を設計し、出力を検証する力”が問われる――そんな実感を持った検証でした。
最後に、現役エンジニアとしての本音を少しだけ。今回いちばん手応えを感じたのは、こちらの指示が具体的になるほど、出力がどんどん“組み込みらしく”なっていったことでした。突き詰めれば、かなり理想に近いコードまで引き出せるのではないか――そんな可能性すら感じます。ただ、その最後の一歩を埋めるのは、やはり前提を知る人間の点検です。私はこれからも、AIを頼れる相棒としてどんどん使い倒しながら、同時に“最後に確かめる自分”であり続けたいと思います。