さくらの高火力 PHYを利用したKV CacheのOffload検証 〜高火力 PHYで作る分散推論基盤 vol.4〜

はじめに
さくらインターネットで高火力 PHYチームに所属している道下です。
本連載では、高火力 PHYで利用しているサーバーと同種のGPUサーバーを利用し、近年注目度を増しているLLMの分散推論基盤に関して、詳細な技術調査や性能検証を行う中で獲得したナレッジを紹介しています。前回の記事では、Prefill-Decode Disaggregation(PD Disaggregation / Disaggregated Prefill)の効力について実測した内容を説明しました。
今回の記事では、推論処理を高速化する基礎的な技術の一つである、KV Cacheの活用に関して詳細に議論していきます。最近はKV Cacheという用語もかなり一般的になってきたように感じますが、技術的なKV Cacheの取り扱いやそれを利用した最適化やパフォーマンス測定に関して、国内のナレッジはそこまで多くないように思います。今回は連載第二回の記事のように、GPUDirect Storageなどの低めのレイヤーも含めて、この技術について説明していこうと思っています。
おさらい
KV Cache自体の説明に関しては本連載第一回の「推論処理の詳細とKV Cache」の章ですでに行いました。これはLLMの推論におけるAttentionの処理によって生まれる計算結果のことであり、初回(Prefill phase)は入力全体に対して計算を行うものの、それ以降(Decode phase)では、このKV Cacheを読み出すことで新規に生成されたToken以外の計算を削減できるというものでした。
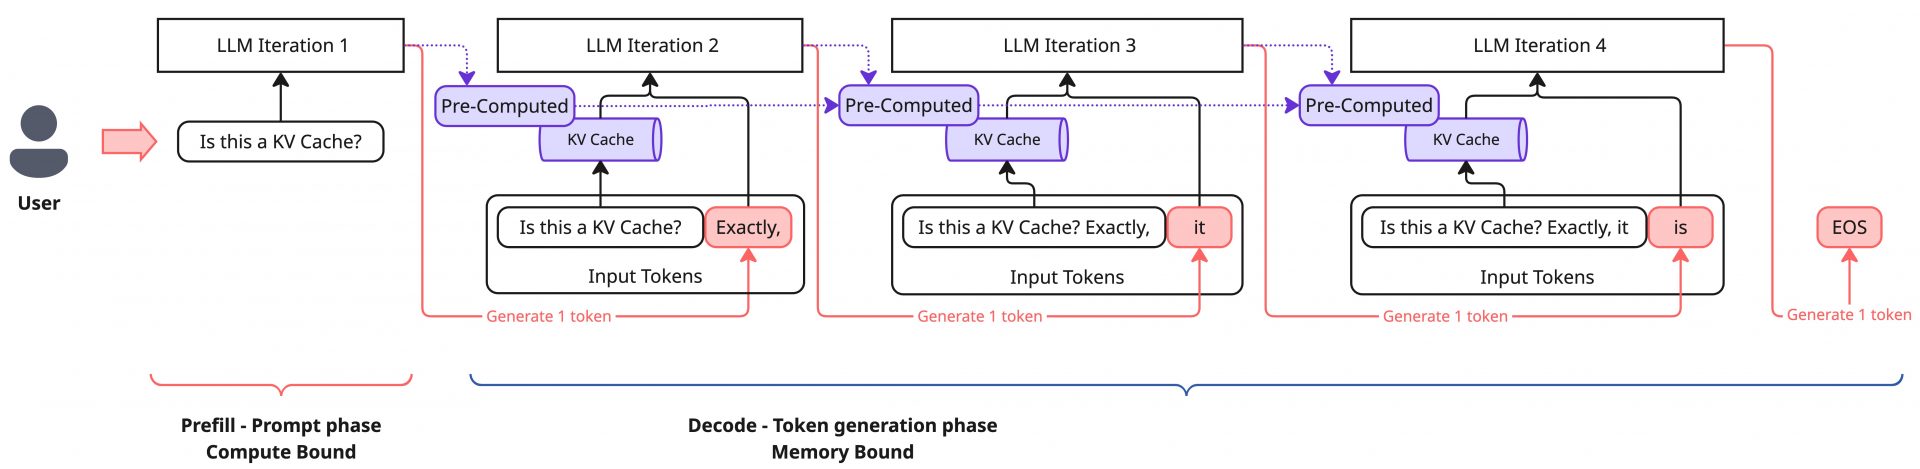
PD Disaggregationの議論で既にKV CacheをPrefill向けのGPUからDecode向けのGPUに転送する話をしていますが、これらはKV Cacheの活用の文脈というより「ボトルネックの少ないLLM推論構成においては、KV Cacheは十分な性能で転送される必要がある」という議論でした。今回はそのような「システム要求によるKV Cacheの取り扱いに関する議論」ではなく「KV Cacheを活用することでシステムとしての性能改善を狙う」という側面に目を向けた議論になります。
まずは、具体的なKV Cacheの利用イメージを獲得するために、KV CacheのOffloadの話、そしてMemory/Storage Tierについて整理した上で、KV Cacheの共有の話を具体的な活用シーンとして紹介し、KV Cacheの活用において考えなければならない課題について整理します。
KV Cacheの活用
KV Cache Offload
GPUを利用して推論モデルをサービングしている場合は、KV Cacheは当然GPUメモリー上に作成されます。ただし、このGPUメモリー上のKV Cacheは、GPUのメモリーに余裕がなくなると破棄されてしまいます。例えば、複数のユーザーリクエストを同時に受けている場合、KV Cacheはそれぞれのリクエストごとに作成されるため、リクエスト数の増大や、各リクエストのコンテキスト長の増大によって、比較的容易にKV Cache用のメモリー領域を消費しきるケースがあります。この場合、新しいリクエストやIn-flightリクエストのコンテキスト増大によって必要になる追加のKV Cache領域を、既存のKV CacheをGPUメモリーから破棄することで確保することになります。
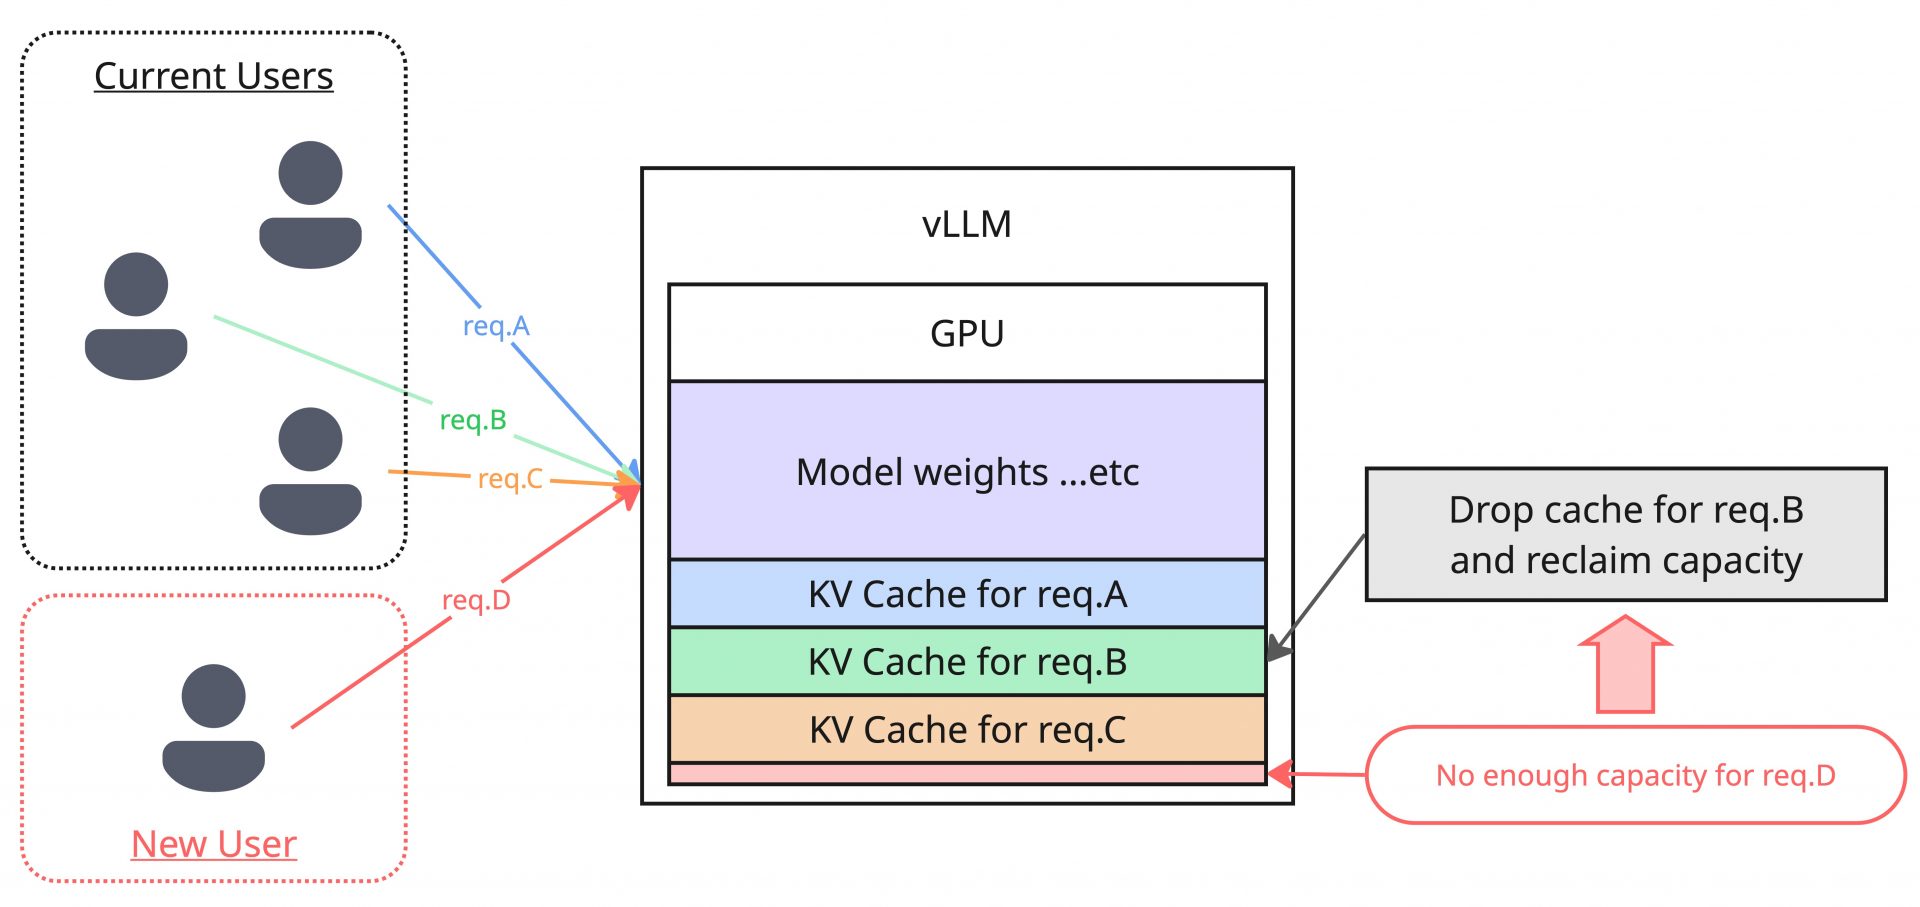
破棄されたKV Cacheを利用していたリクエストは、破棄された部分のAttention演算を改めて行うことになります。深刻なエラーになるわけではありませんが、過去に行ったものと同じ演算を繰り返すことになるため、無駄にCompute Resourceを消費することになります。
これを緩和するために、KV CacheをGPUメモリー以外のデータ格納先(ホストのメインメモリーやローカルストレージ、リモートストレージなど)に退避する技術があります。これにより、本来であればGPUメモリーを消費しきる負荷のリクエストであっても、一時的にKV Cacheを外部領域に退避させ、また必要なタイミングで読み込むことで、Attentionの再計算を回避できます。
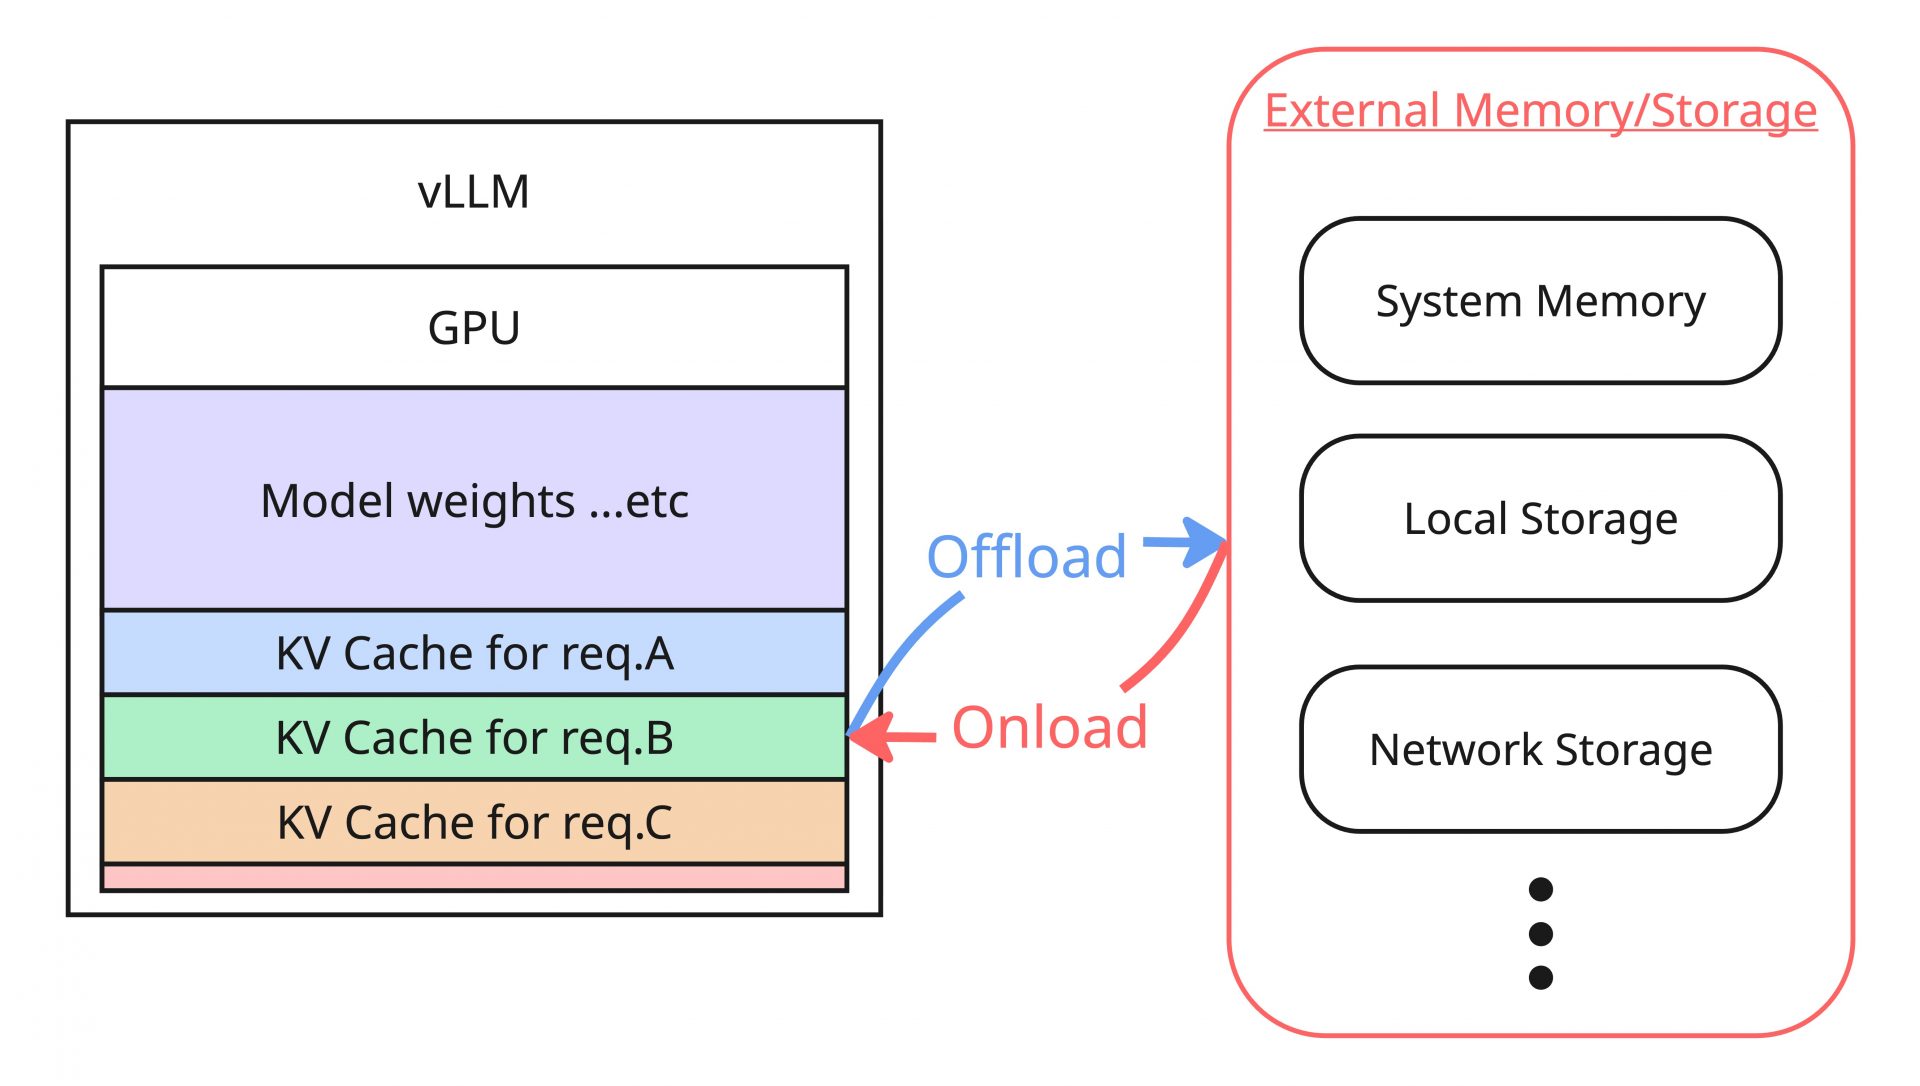
ここで重要な議論として、KV Cacheの退避先によっては、KV CacheをGPUメモリー上に読み込む上での性能に差が出てくることになります。メインメモリーへの退避、つまりGPUメモリーとメインメモリー間でのデータ転送はシステム内部のDMA転送となるため十分に高速であることが見込まれますが、ストレージの場合はどうでしょうか? Storage I/Oに関しての詳細はまた後ほど触れるとして、ここで説明したKV Cacheに対するメモリーやストレージについて、業界の議論を交えて一度俯瞰的に整理します。
Memory/Storage Tier
前述した「KV CacheをGPUメモリーとは別の領域に保存し再利用する」という方式は、近年の推論システムでは一般的に採用されるものとなっています。これは特に近年のAgentic AIのワークロードによって、リクエスト数の増大や、長コンテキスト化がより加速したこと、さらにはKV Cacheを複数の推論インスタンスや複数のノードで共有することが必須になってきたことが大きな要因の一つです。
KV Cacheを格納できる推論システム上の領域に関して、NVIDIAは次のようなTier図で整理しています。これはKV Cache向けのデータ領域を階層的に整理した上で、それぞれの階層のストレージがKV Cacheの観点からどのように利用されるかを端的に表現した図になっています。
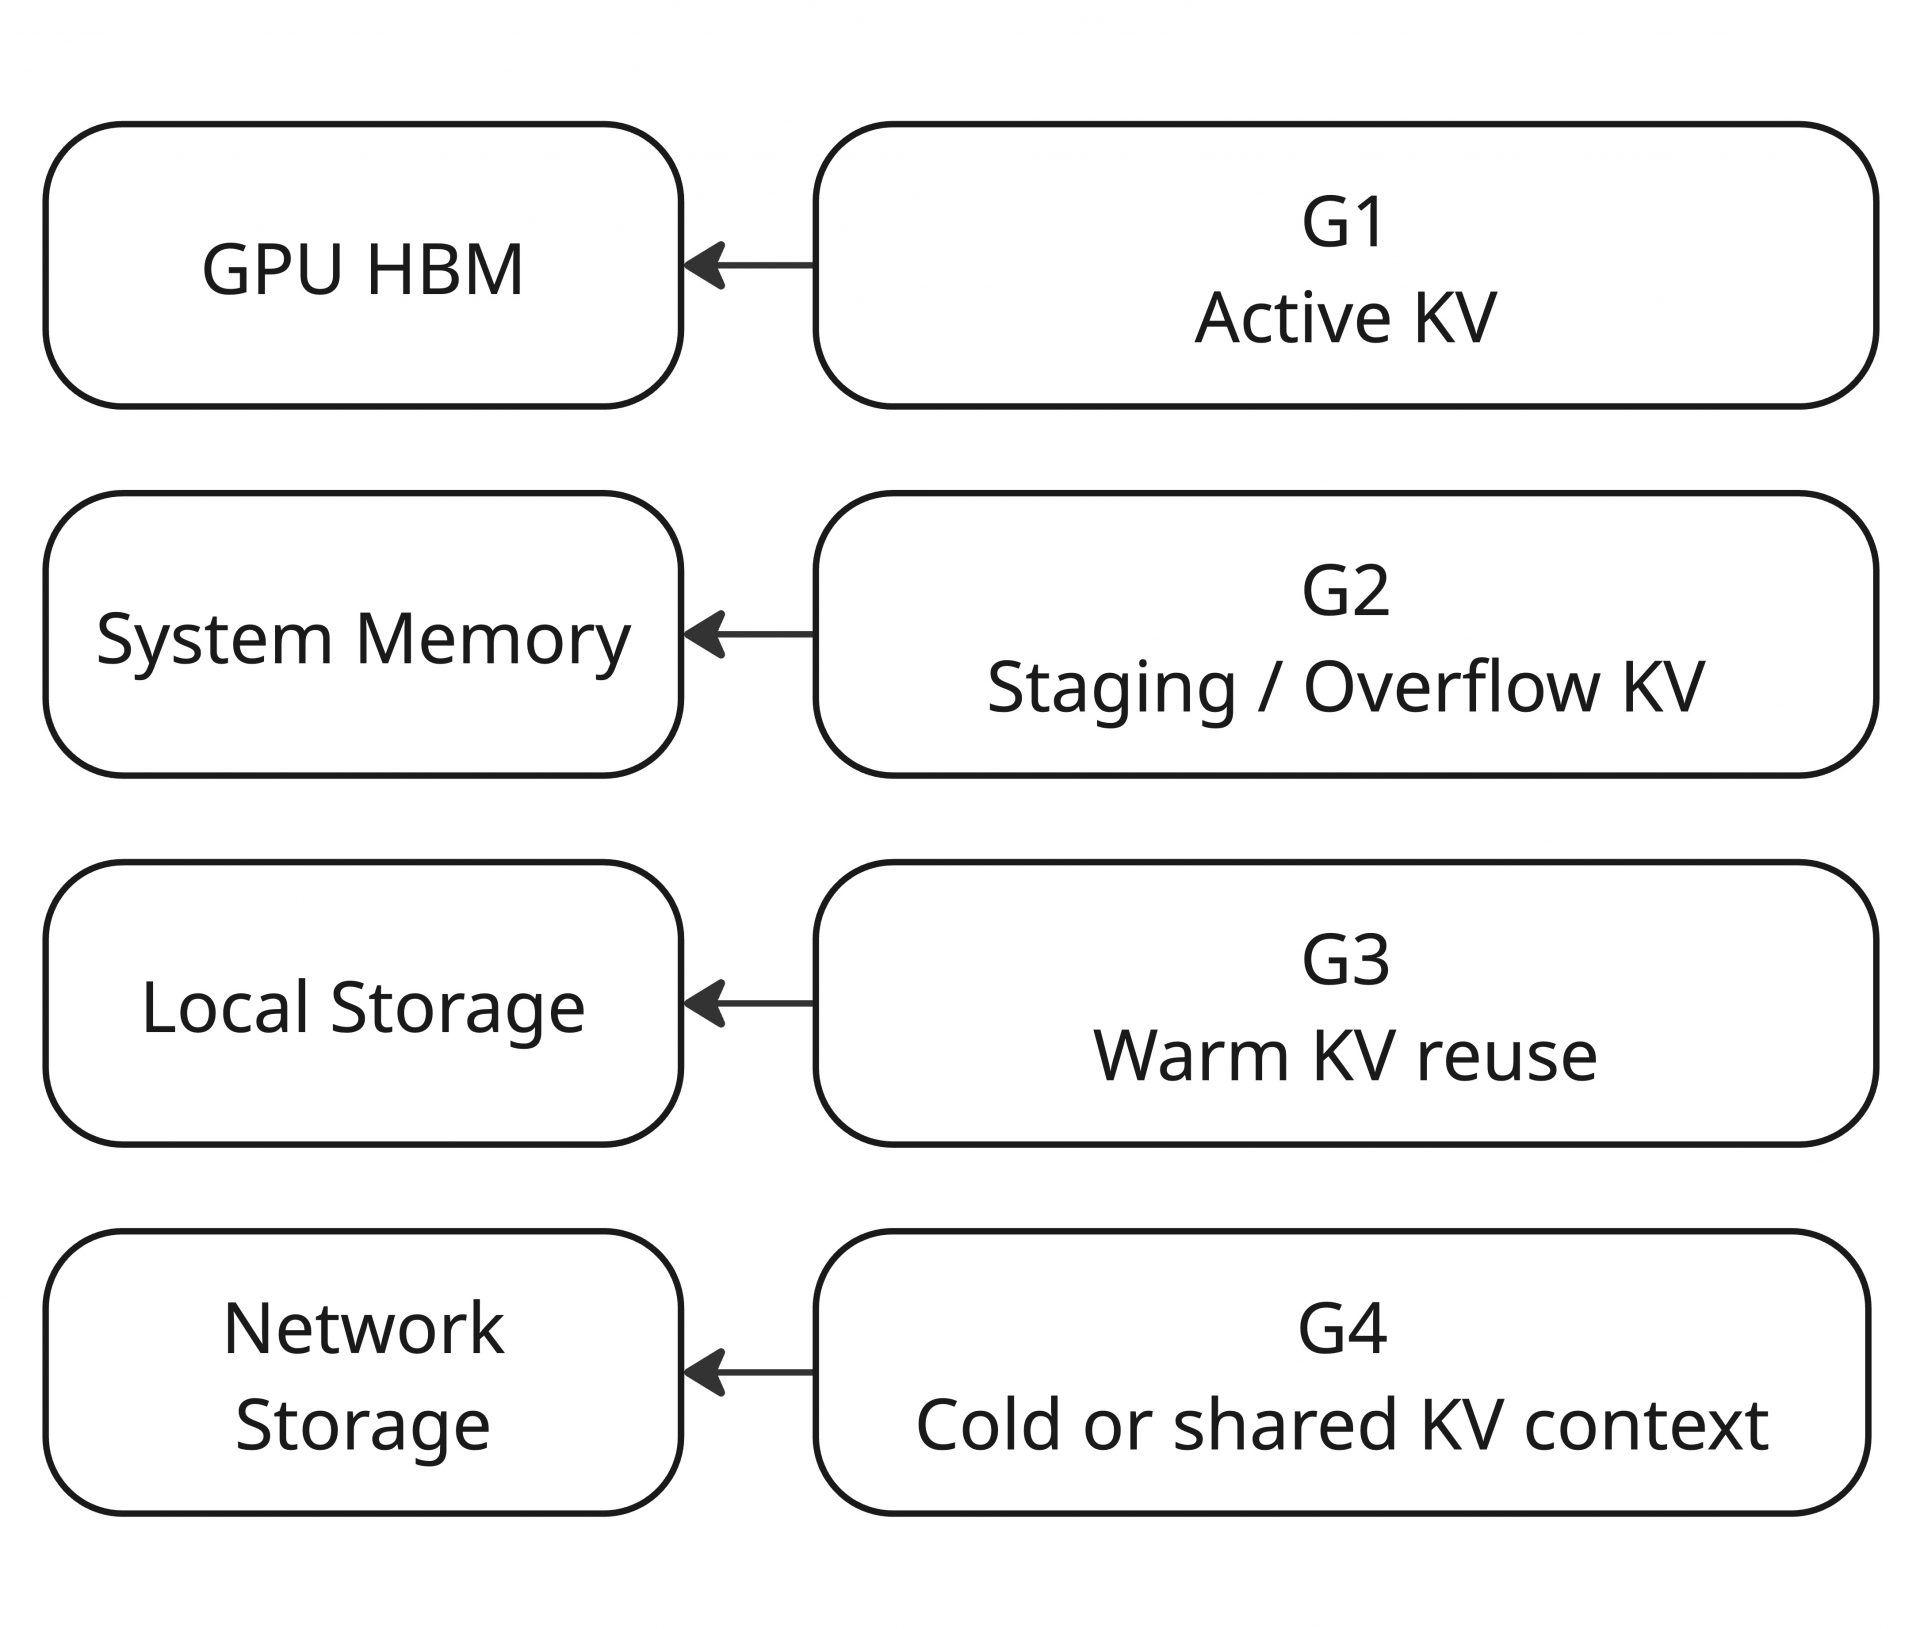
- G1(GPU HBM): アクティブな生成処理のために利用される、最も低いレイテンシーを提供するデータ領域。ただし容量が極端に制限される。
- G2(System Memory): HBMに収容できなくなったデータをステージングするホストメモリー領域。近い将来再利用される可能性があるデータを保存する。HBMよりも多くの容量を提供するがアクセスレイテンシーは若干高くなる。
- G3(Local Storage): 比較的短い時間枠で再利用されるウォーム状態のKVデータを格納する。ただしシングルノードに固定されている領域のため、管理やメンテナンス性に乏しく、拡張性にも限界がある。
- G4(Network Storage): ノード間で長期間保持、共有可能なデータ領域。即時性の必要な処理には向かないものの、クラスタレベルで推論状態を永続的に再利用可能になる。
この図からも分かる通り、メインメモリーやローカルストレージ、ネットワーク越しのリモートストレージの全てを活用しKV Cacheを最適に取り回す世界観になっています。裏を返せば、KV Cache用ストレージも織り込んだシステム全体の構成がより重要になってきている、ということです。
ご存知の方も多いかもしれませんが、NVIDIAは近年、上記のTier図にG3.5として推論向けのStorage Tierを追加定義しています。これについては本筋から外れるため、本稿の最後にて軽く触れることにします。
次に、このStorage Tierの議論も踏まえた上で、KV Cacheを複数の推論インスタンスや複数のノードで共有するという考え方について一歩踏み込んで説明していきます。
複数インスタンス間でのKV Cache共有
前述した通り、KV CacheはAttentionの処理によって生じるものであり、モデルが採用しているAttentionの方式、および入力内容によって決まります。そのため、例えば複数のインスタンスで同一モデルをサービングする(= 同一のAttentionの方式を採用している)構成で、KV Cacheをインスタンス間で何かしらの手段によって共有可能にした場合、同じコンテキストに対して、その時点までのAttentionの計算は両方のインスタンスで省略可能になるということになります。
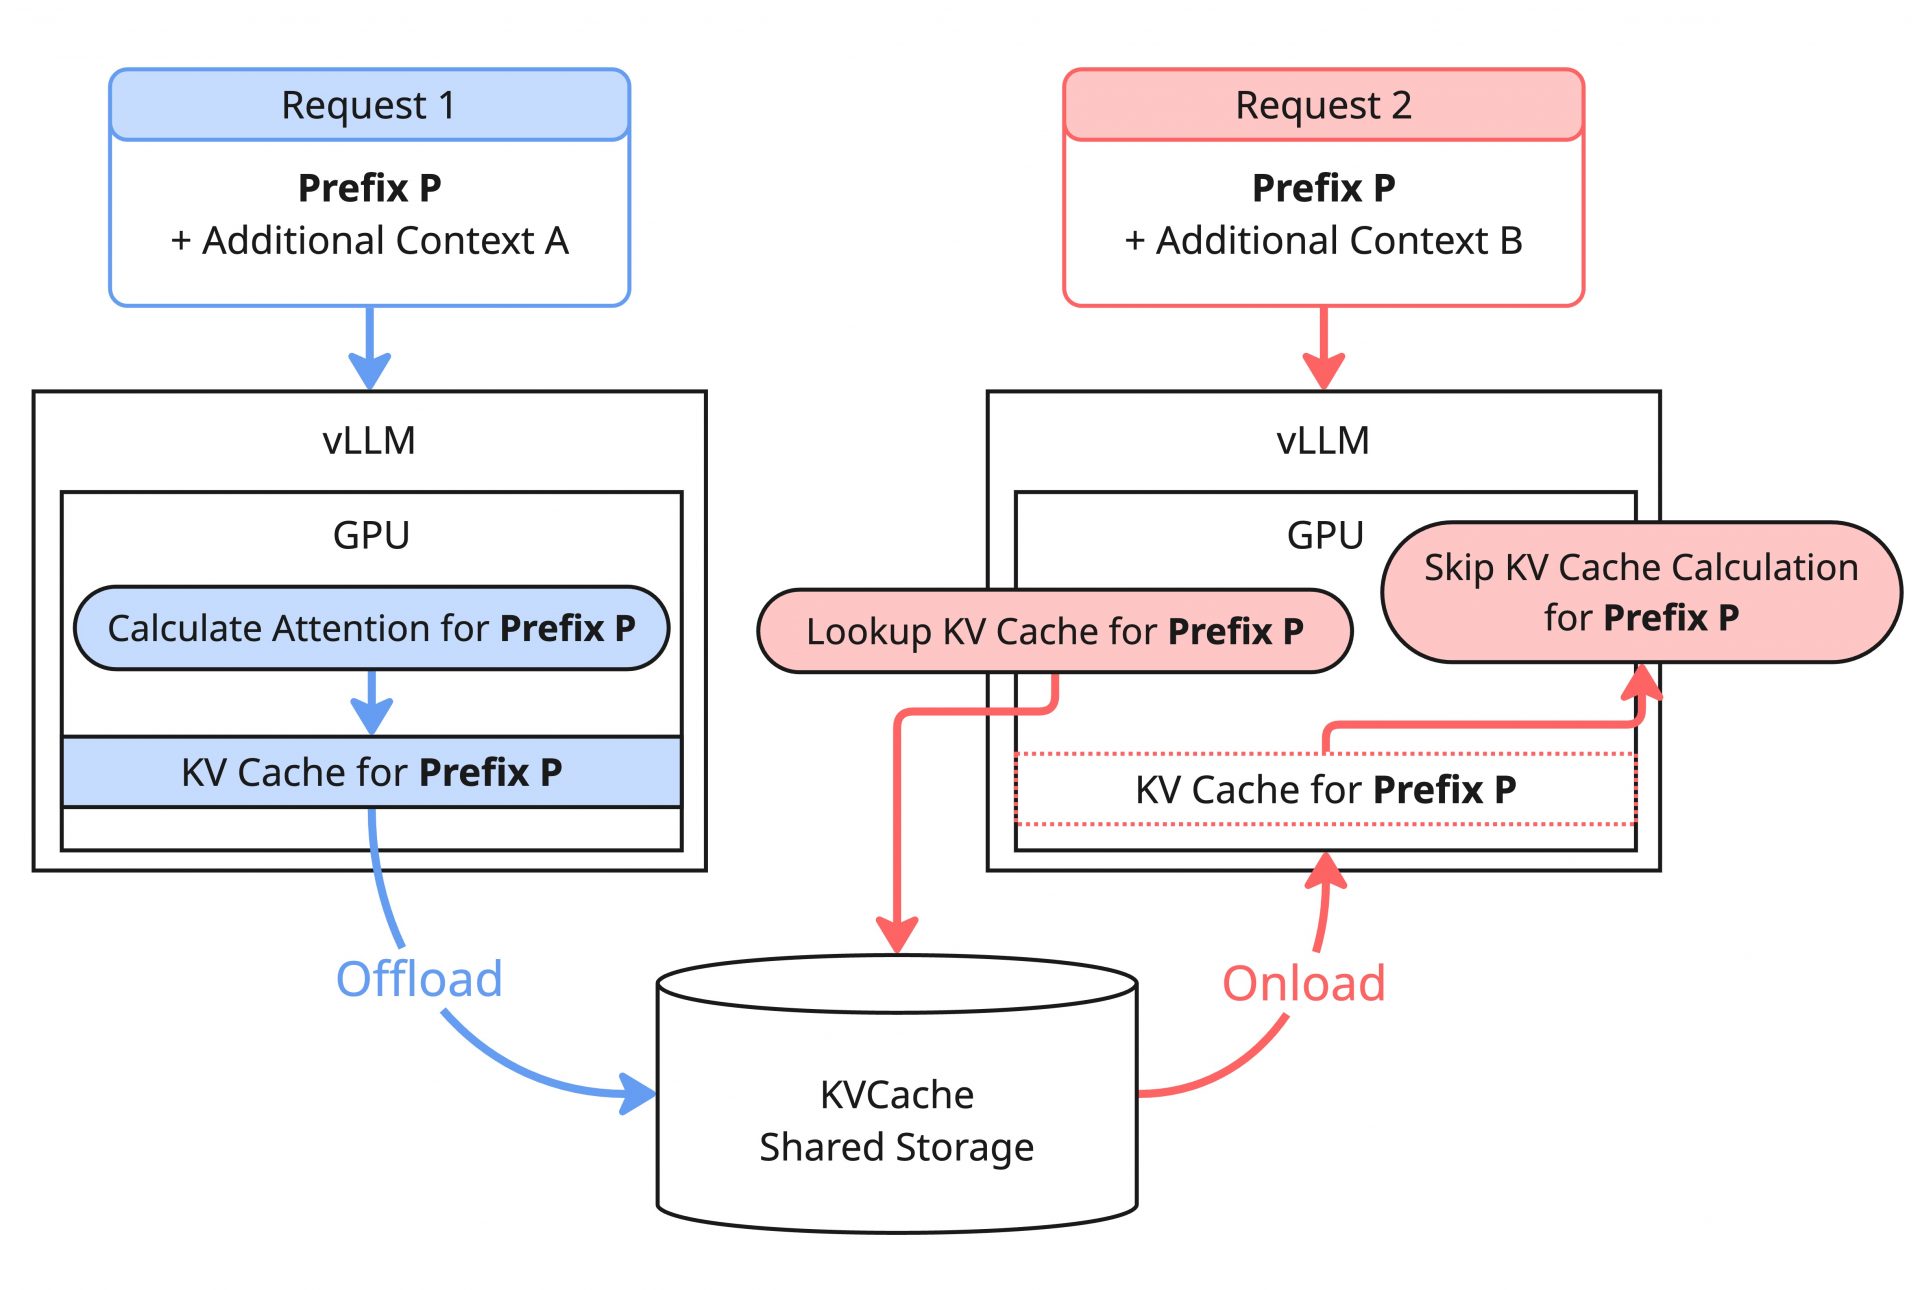
この場合、別のインスタンスですでに計算済みのAttentionの結果が他のインスタンスでも参照可能になるため、共有可能な範囲において、同様のPrefixを持つリクエストに対して、TTFT(Time To First Token)を削減する効果が見込まれます。
この議論をする場合は、本来複数インスタンス間のRouting技術についても踏み込んで議論するのが筋です。推論システム特有のルーティングとしてルーター側の履歴からPrefixの所在を推定するPrefix awareなルーティングや、推論エンジンからKV Cacheの実際の所在(KV Eventsなど)を受け取るKV Cache awareなルーティングが存在し、これらによって同様のコンテキストを既に処理済みのインスタンスに優先的にリクエストがルーティングされる、ということが実現されるためです。これだけ聞くとKV Cacheを複数インスタンス間で共有するメリットは薄いように感じられます。ただし、実際にはこれらのルーティングは特定のインスタンスに負荷が集中する懸念があるため、Load awareなルーティングも併用されることがあります。このようなケースではキャッシュヒットよりも負荷分散を優先したルーティングが行われるケースがあります。この時、KV Cacheの複数インスタンス間での共有は十分な効果を持つでしょう。このように実際はシステム全体での最適化の文脈を考慮する必要があり、KV Cacheの共有も全体的な最適化のうちの一要素として捉えるべきでしょう。
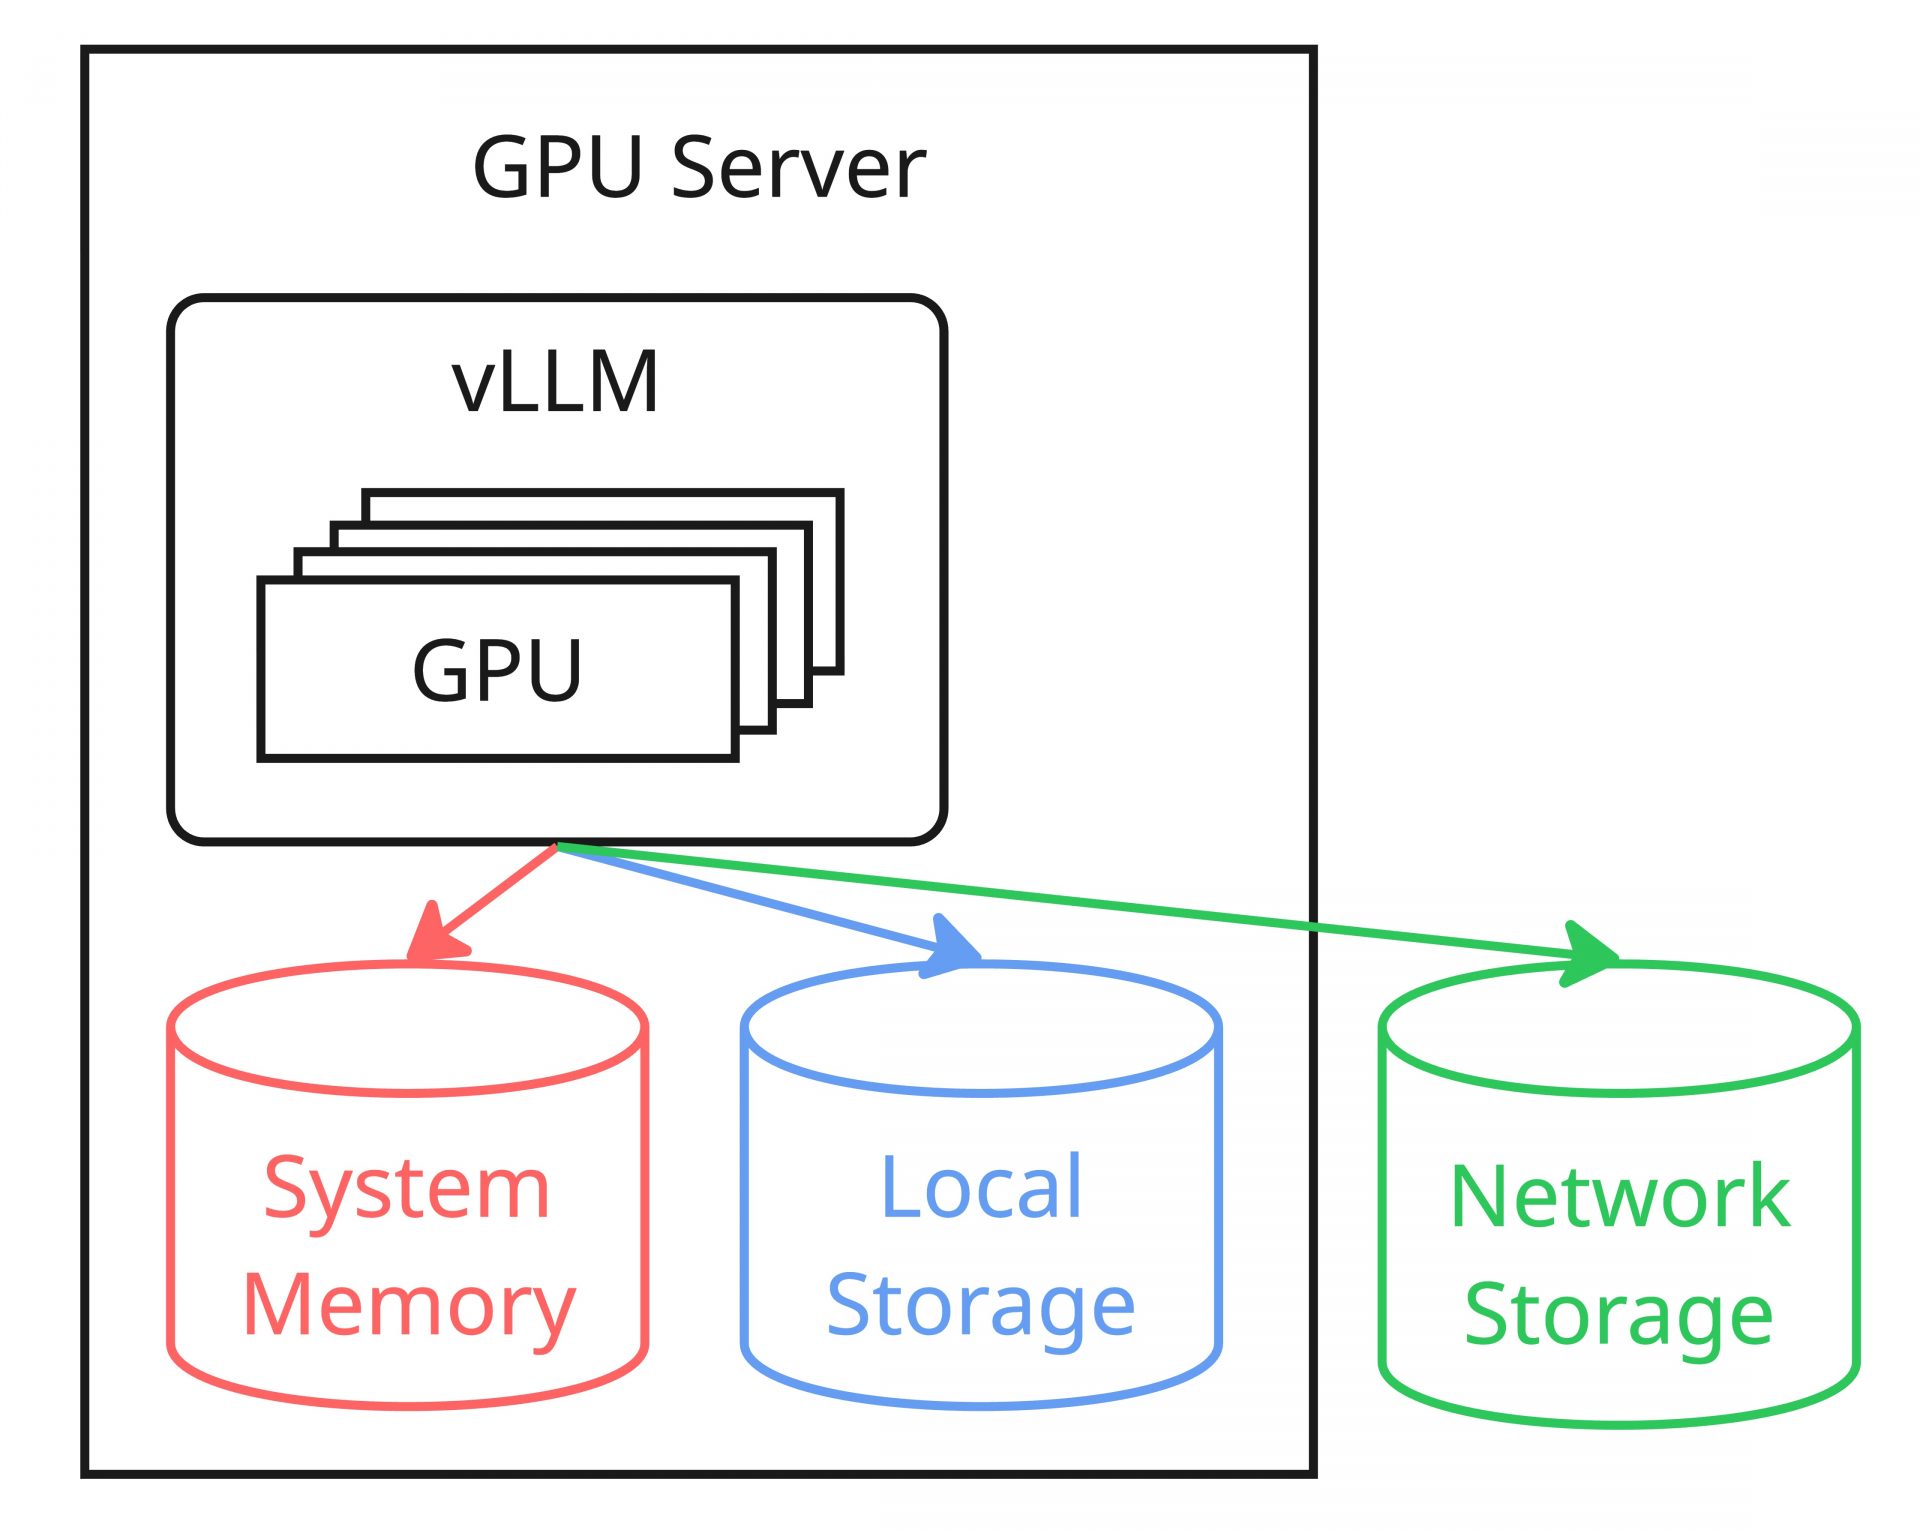
さて、実際に推論インスタンス間でのKV Cacheの共有を実現しようとした場合、デプロイ方式によって構成は色々検討できることになります。例えば、複数のGPUを搭載しているシングルノードに対して複数のインスタンスを起動するケースでは、それぞれのインスタンスはメインメモリー、ローカルストレージ、リモートストレージのいずれの方法でもKV Cacheを共有できます。しかし、当然ながら性能という意味でメインメモリーを利用した共有が最も優れており、ローカルないしリモートのストレージを利用するとより多くのKV Cacheを格納できます。
さらに、複数のノードでそれぞれ推論インスタンスを起動している場合は、ローカルのデータ保持領域では共有できないため、基本的にはリモートストレージを介してKV Cacheを共有することになります。
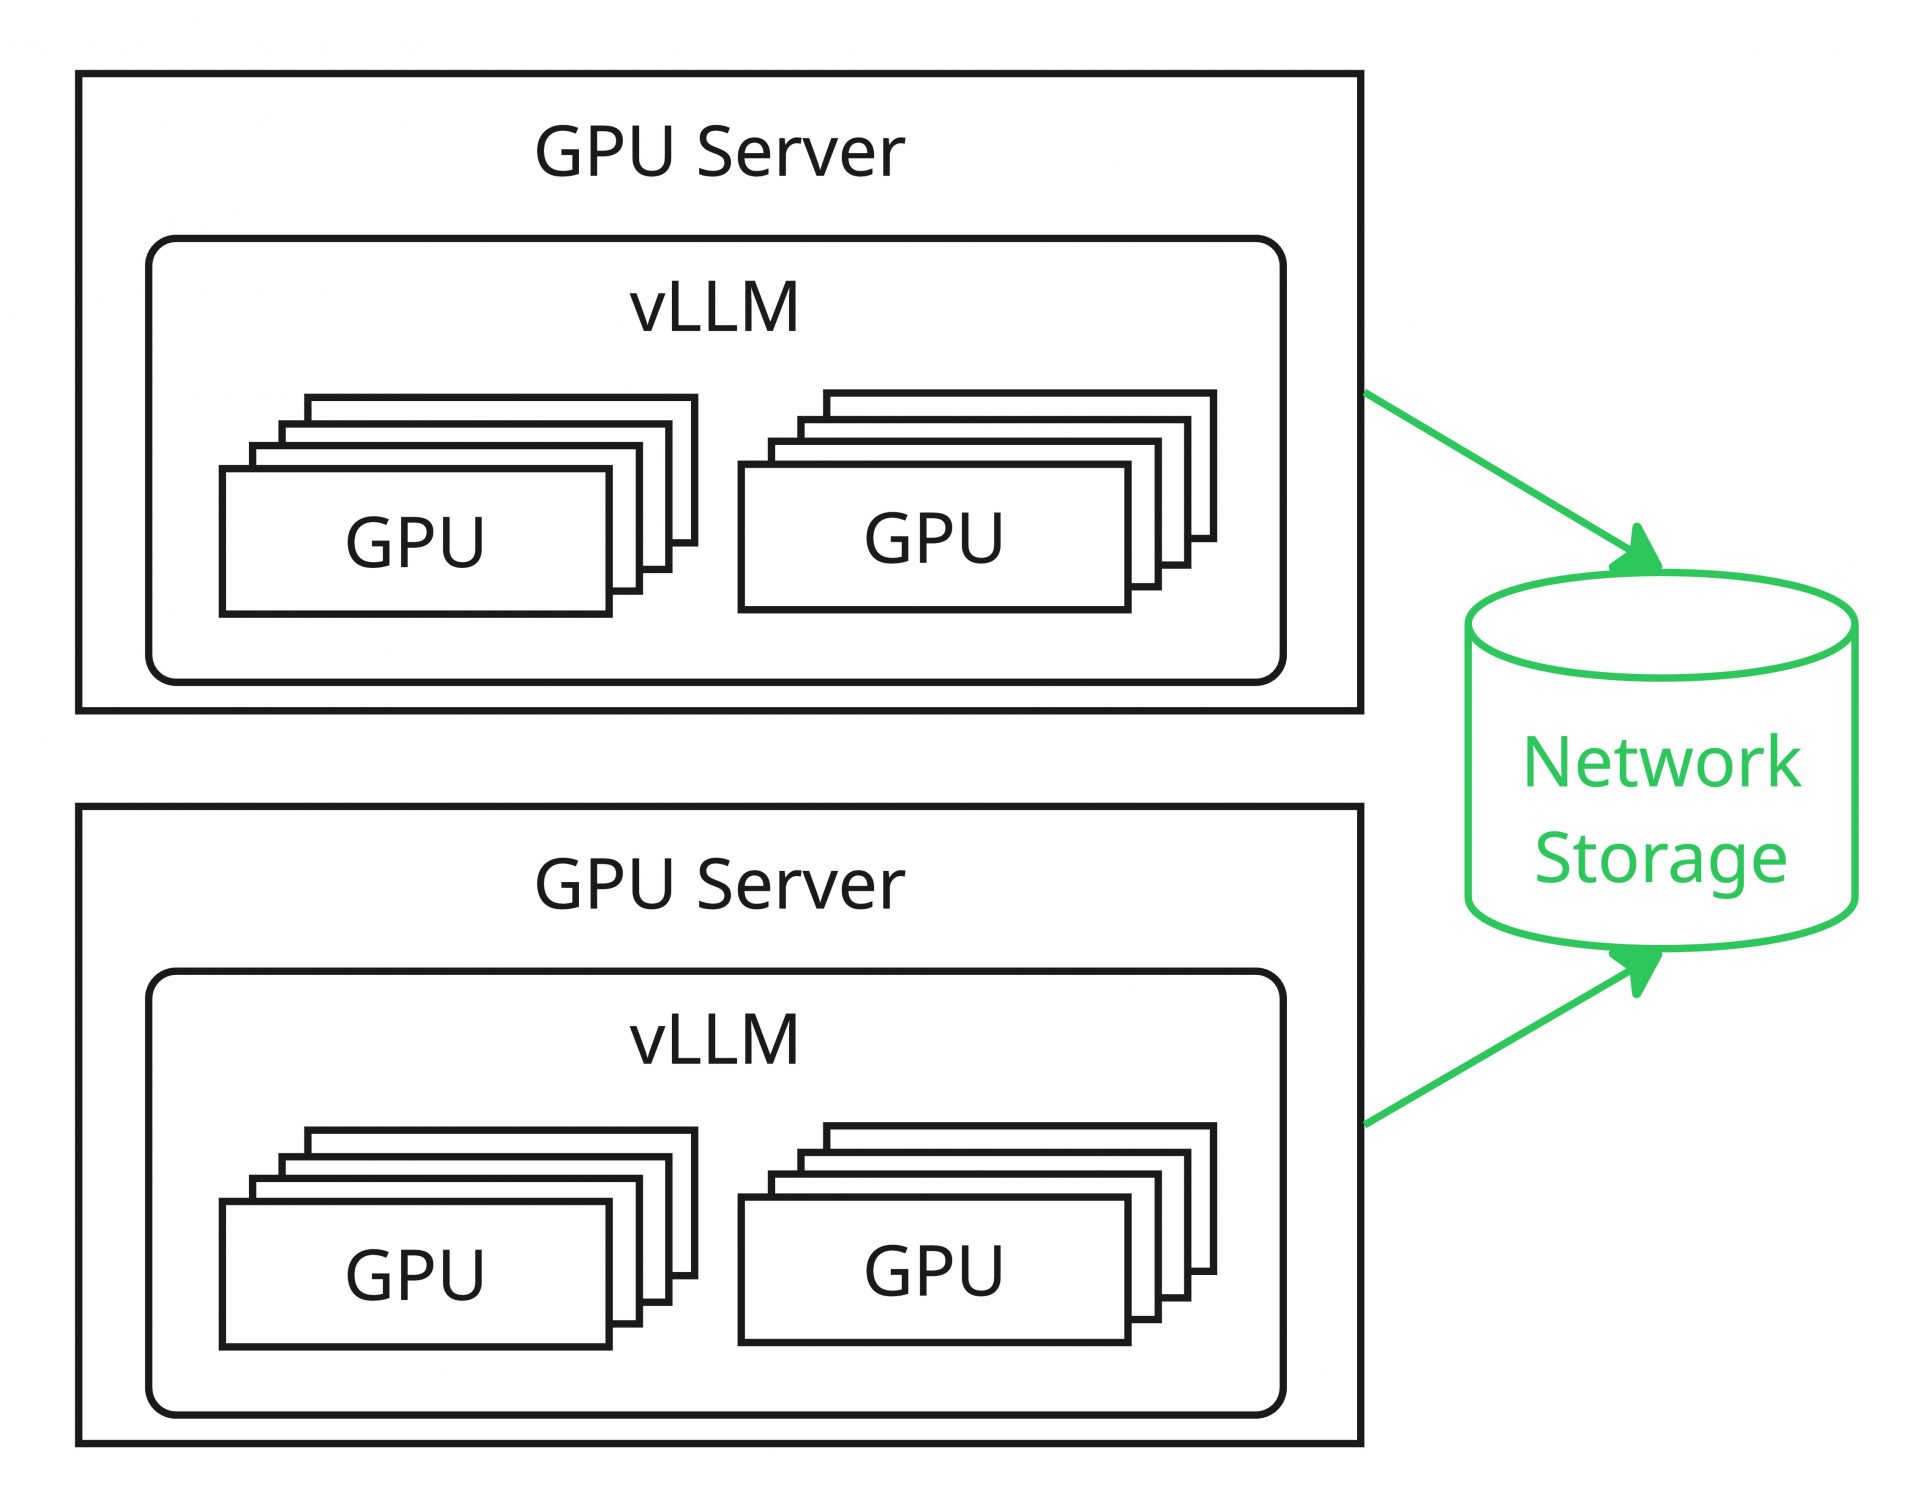
このように構成の違い、利用可能なストレージの違いによって、KV Cacheをどのように利用できるかが変わってくるため、設計の際にはこれらの考慮も必要です。
KV Cache向けStorageの課題とGPUDirect Storage
KV Cacheの共有において特にストレージを利用するケース(G3, G4)は、GPUメモリーやメインメモリーと比較すると安価で大容量なデータ領域であるメリットや、特にリモートストレージの場合は複数インスタンス間でのKV Cache共有を可能にするため、システムの拡張という側面のメリットがあります。一方、これらのStorage I/O速度が十分なのかという現実的な懸念点があります。メモリーに対するRead/Writeと比較するとStorage I/Oは基本的に遅いため、結果的にこれらのストレージを活用しても、I/O性能が十分でないために、KV Cache活用による十分な性能改善が見込めないという結果に繋がりかねません。
Storage I/Oの高速化の文脈で、よく名前が挙がるのはGPUDirect Storage(GDS)です。GDSはGPUメモリーとストレージの間のデータ転送を最適化する技術で、もともとKV Cacheのために作られた技術ではありません。しかし近年は、KV CacheのOffloadを担うソフトウェアや、そのストレージを提供するベンダーの資料でも、GDSへの対応がたびたび打ち出されています。
では、GDSを使えばKV CacheのStorage I/Oは本当に速くなるのでしょうか。結論として、これは「GDSをどのような構成で使うか」に大きく依存します。そしてそれを判断するには、GDSが内部で何をしているのかを理解しておく必要があります。
個人的な主観ですが、GDSのコンセプトは非常に明確な一方で、実際にその技術を紐解いてみると、適切に利用するにはかなり前提知識を要する技術になっている印象です。最近のGPUDirect Storageの公式ドキュメントはかなり内容が充実してきていますが、パッと読んで詳細に理解するのは難しいでしょう。実際のところ、GDS自体はあまり意識せずに使えてしまう技術ではあるため、利用に際して困ることは少ないかもしれませんが、エンジニアとしては適切に利用するためにある程度の理解を獲得しておくべきだと考えています。そのため、やや低レイヤーの議論になりますが、本連載では誌面を割いてGDSの詳細な解説を試みます。
GPUDirect Storage(GDS)
この節では、GPUDirect Storage(GDS)について詳細に説明していこうと思います。以降の内容は、連載第二回のGPUDirect RDMA(以降、GDRと呼称)の内容を前提としています。もしまだ読まれていない場合はまずそちらを参照いただくことを強く推奨します。
本誌面でのGDSの説明は本稿執筆時における私の理解に基づくものであり、内容の一部に誤りがある可能性、および今後実装の変更を伴う可能性があるため、その点に関してはご了承ください。ただし、公開されている範囲で関連するソースコードの確認などを行うなど、現時点で可能な限り正確な情報をお伝えできるように努めています。また、詳細には書ききれない部分も多く、一部説明を省略したり誤解を与える表現になっている可能性がありますが、ご了承いただけると幸いです。
GPUDirect Storageの概要
GDSのコンセプトは、GPUメモリー上のデータをメインメモリー(バウンスバッファ)を介さずにストレージへ転送する技術です。ここで「コンセプト」と表現しているのは、GDSを利用したデータ転送には「メインメモリーを介するケース」もあるからです。これについては詳細を後ほど紹介しますが、本稿においては「GDS」という単語は「メインメモリーを介さないことを必ずしも意味しない用語」として取り扱います。
また、GDSを議論するにあたり、ローカルストレージとリモートストレージはかなり状況が異なります。そのため、本稿においてはこれらを明確に区別するために、ローカルストレージに対するGDSを「Local GDS」、リモートストレージに対するGDSを「Remote GDS」と呼称し分けることとします。
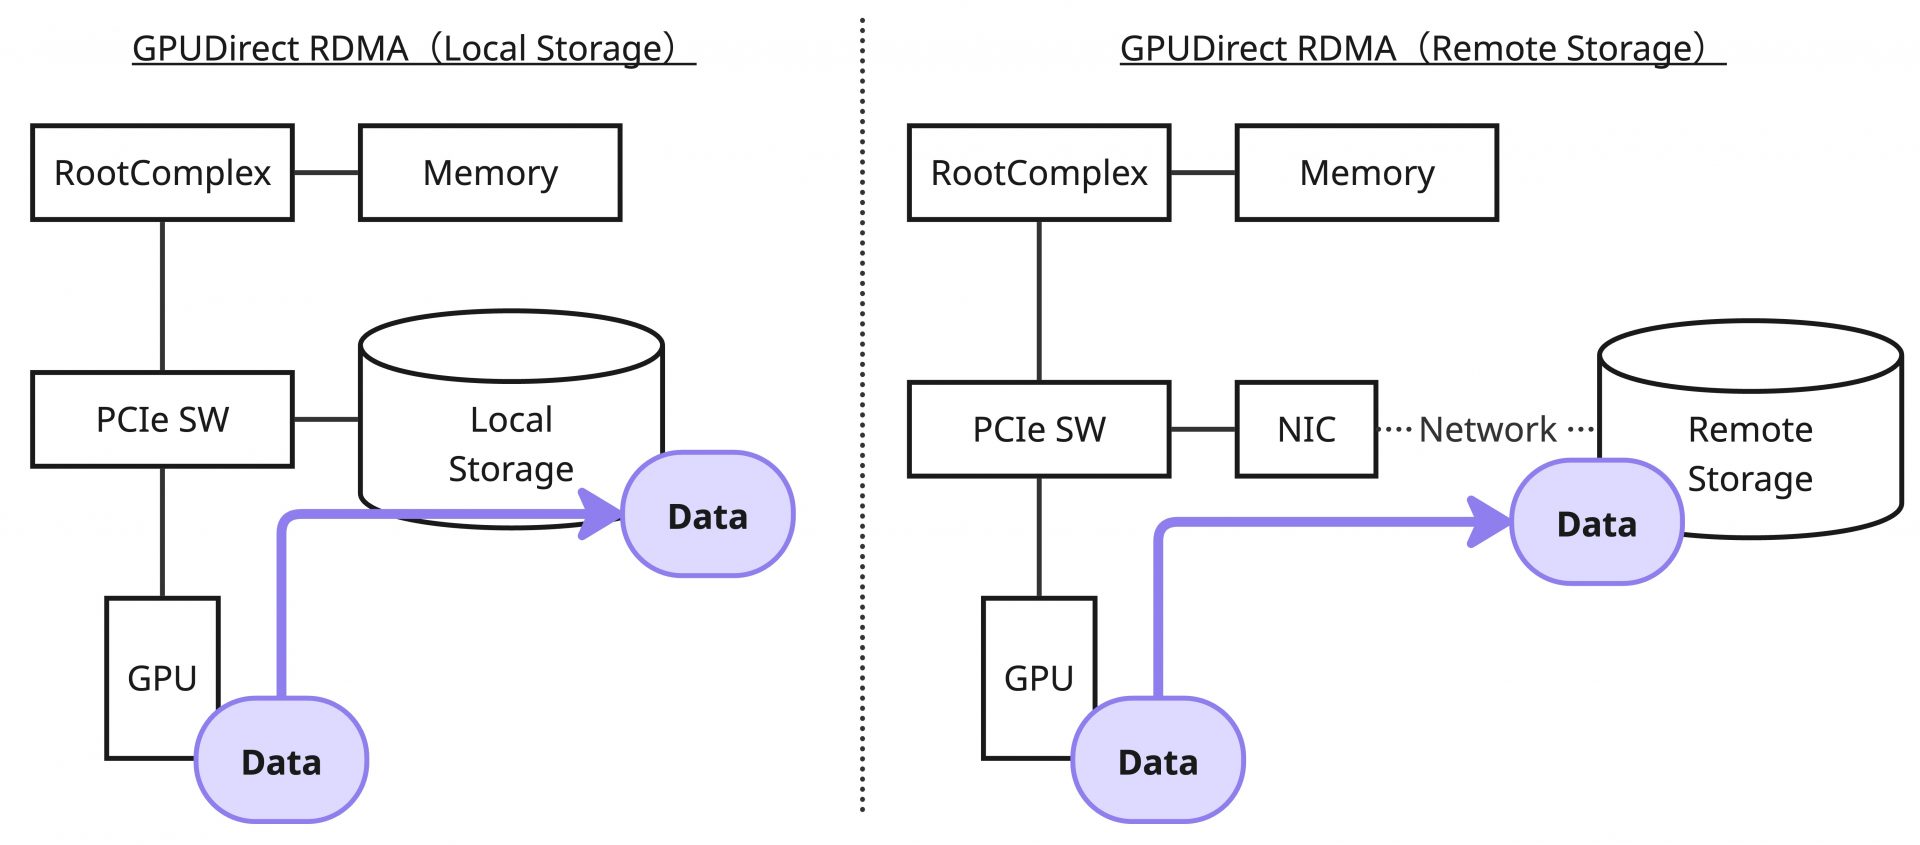
GPUDirect Storageの詳細
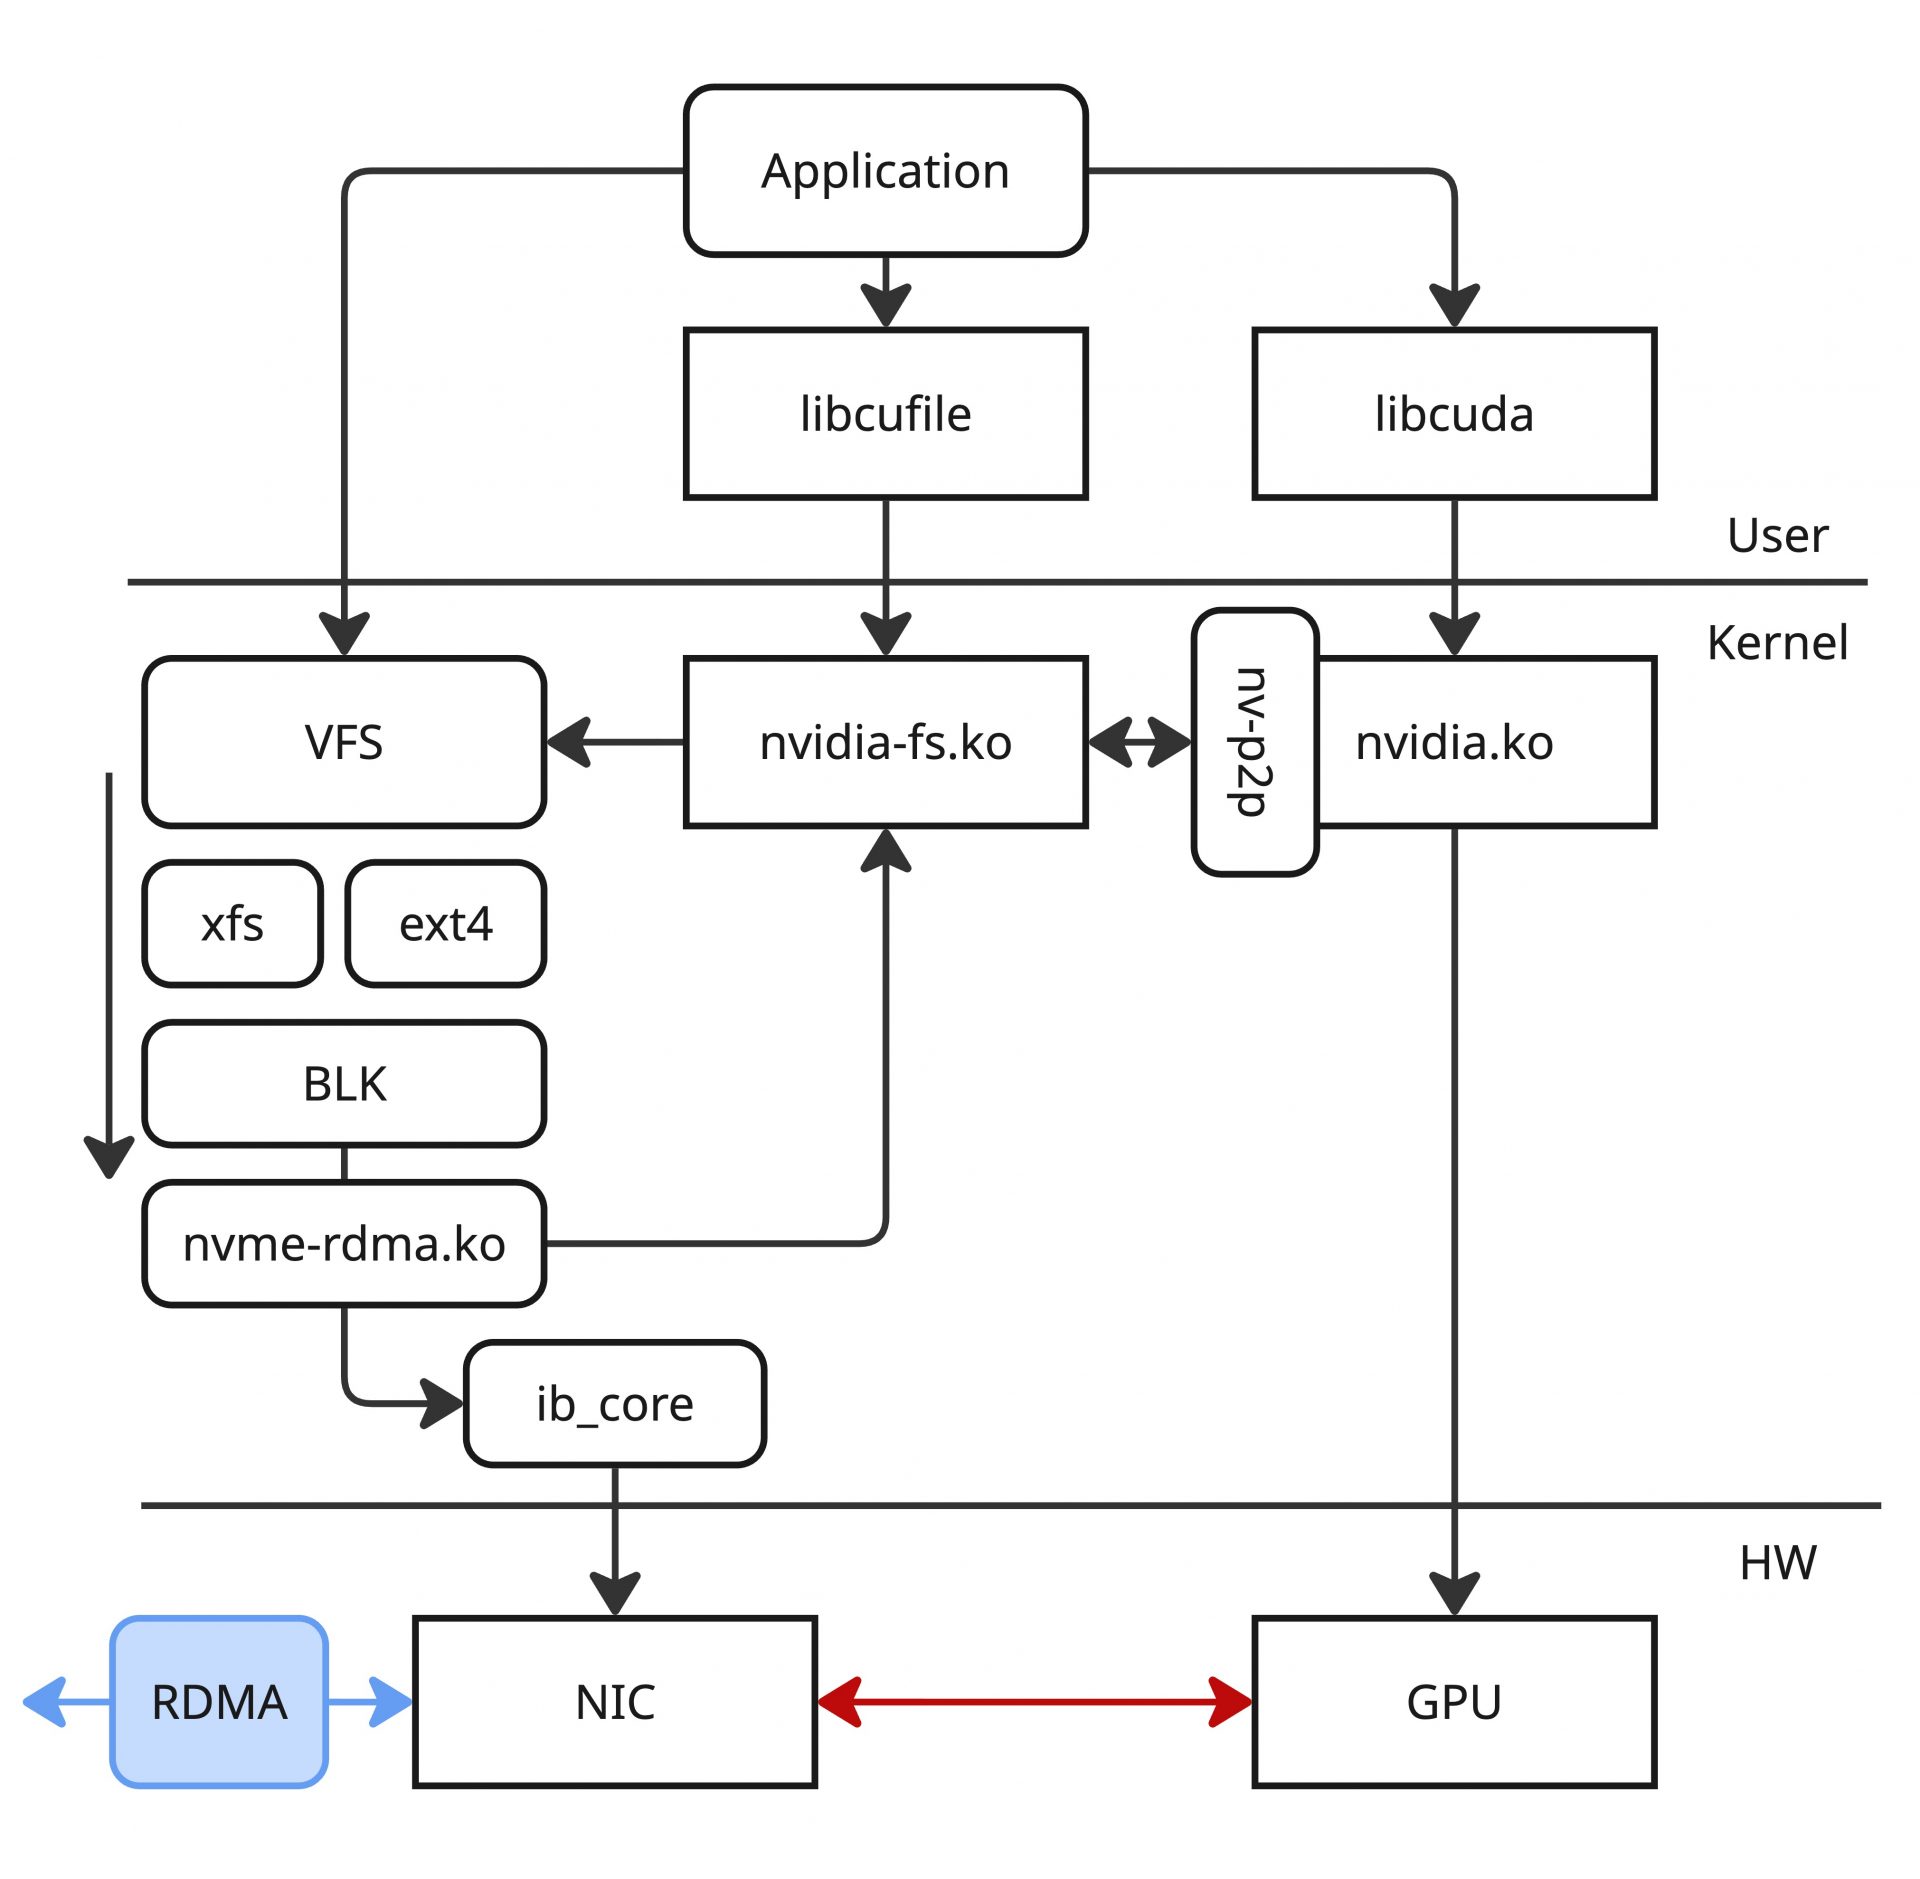
まずは全体像を掴むために、GDSの処理をユーザースペース、カーネルスペースに分けて整理した概要図を以下に記載します。
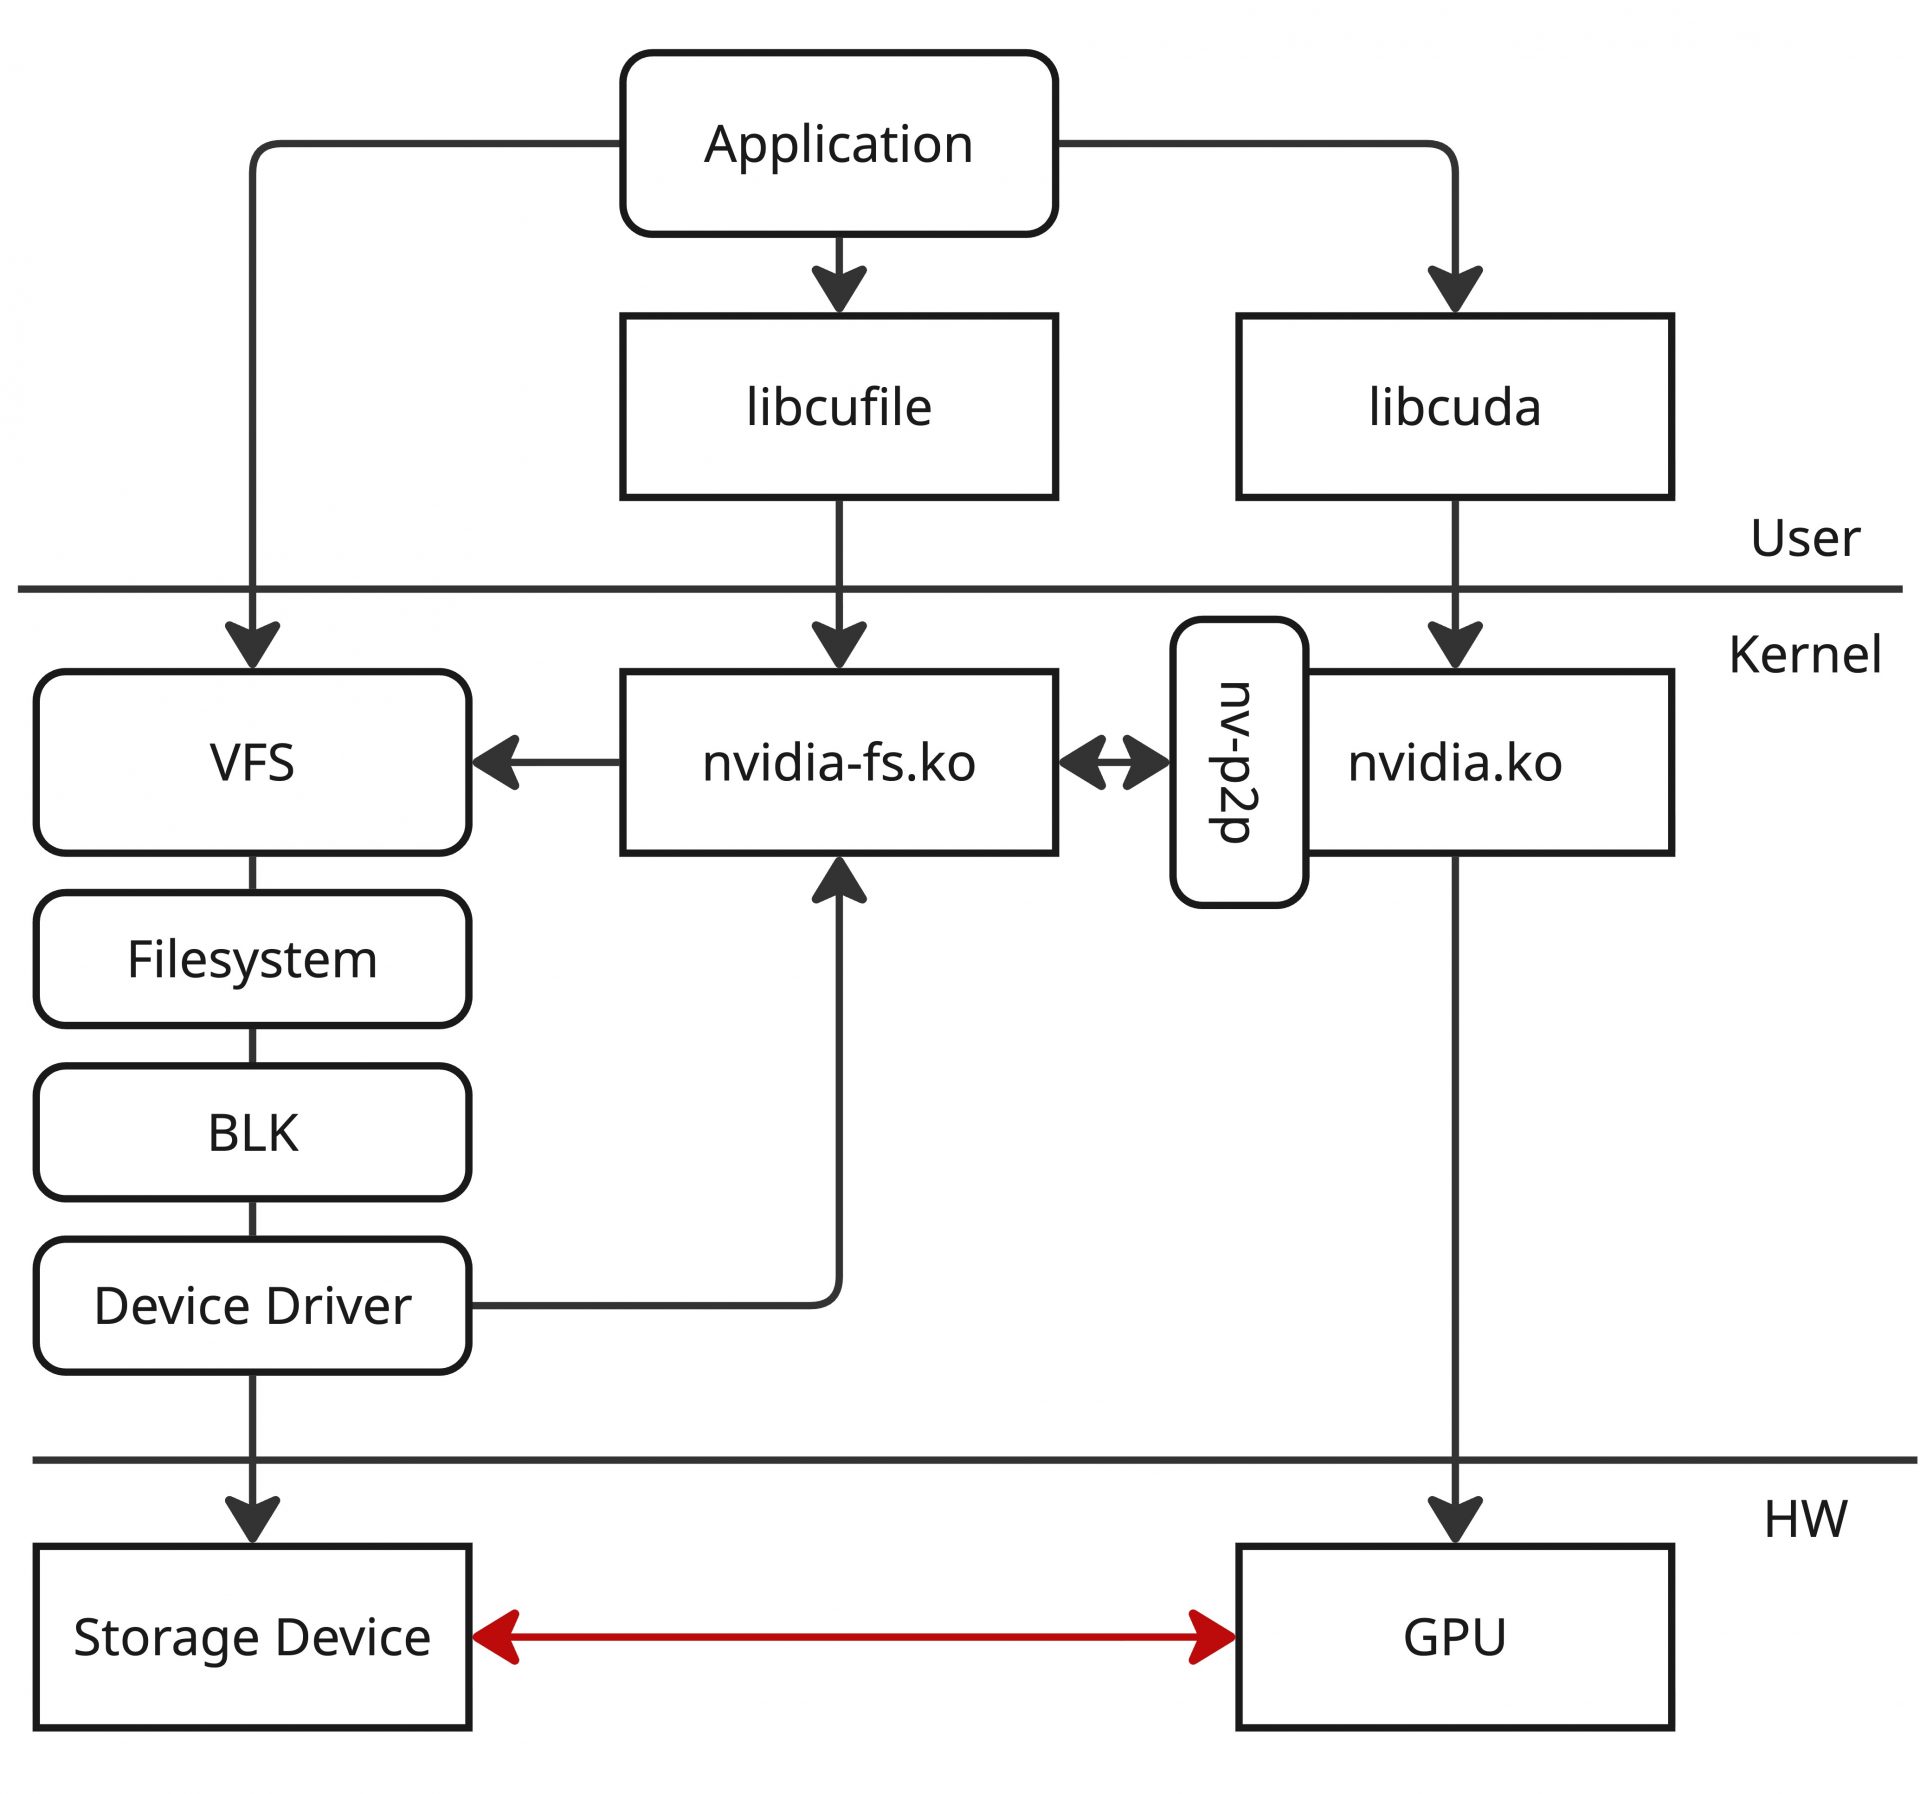
GDSは大きく分けて、カーネルオブジェクトであるnvidia-fs.koと、これを操作するためのユーザースペースライブラリであるlibcufileの2種類を提供します。ユーザースペースのプログラムからは、libcufileが提供するcuFile APIを利用する形で、GDSを利用するロジックを記述できます。
ここでGDSの処理を大きく分けると、次の2系統になります。
- GPUバッファの登録・ピン留め:
cuFileBufRegisterなどの呼び出しを受けて、nvidia-fs.koがGPUバッファのピン留めや、その管理を行う - I/Oの発行とデータ転送:
cuFileRead/cuFileWriteなどの呼び出しを受けてI/O処理を実施する。ただしnvidia-fs.koがI/O処理を独自に実装し直すわけではなく、shadow buffer(後述)を指す構造体を作り、ファイルシステムに処理を委譲する。それ以降は通常のLinux kernelのI/Oパス(ファイルシステム → ブロックレイヤー → デバイスドライバー、NFSのようなネットワークファイルシステムではブロックレイヤーを通らず、RPC/トランスポート層を経由)で処理されるが、ドライバー層からnvidia-fs.koを利用し、shadow bufferと実際のGPUアドレスの対応付けを行う。
一口にStorage I/Oといっても、カーネル内部のストレージ処理は非常に複雑です。そのため、再実装せずに既存の仕組みを使うこの構成は自然でしょう。
一方で、GPUとストレージ間の直接のデータ転送を実現する上での課題は、第二回のGPUDirect RDMAの議論と同様に、GPUメモリー上のアドレスの解決です。アプリケーションレイヤーからcuFile APIを叩く場合、事前にlibcudaを経由して取得したGPU VAを利用することになりますが、最終的なI/Oの発行の前にはこれをLinux kernel側から取り扱い可能な形にする必要があり、結論をいうとこれはGDRと同様にnv-p2p APIを利用する形で実現されています。
このアドレス解決が必要になるのは、VFSに処理を委譲した後、対応するデバイス向けのI/Oを担うドライバー部分になります。そのため、関係するドライバー(NVMe、NVMe-oF、NFS over RDMAなど)には、NVIDIAが提供するGDS対応版の処理が組み込まれたものを利用することになります。これらはNVIDIAから提供されるmlnx-nvmeなどのパッケージ群で配布されています。
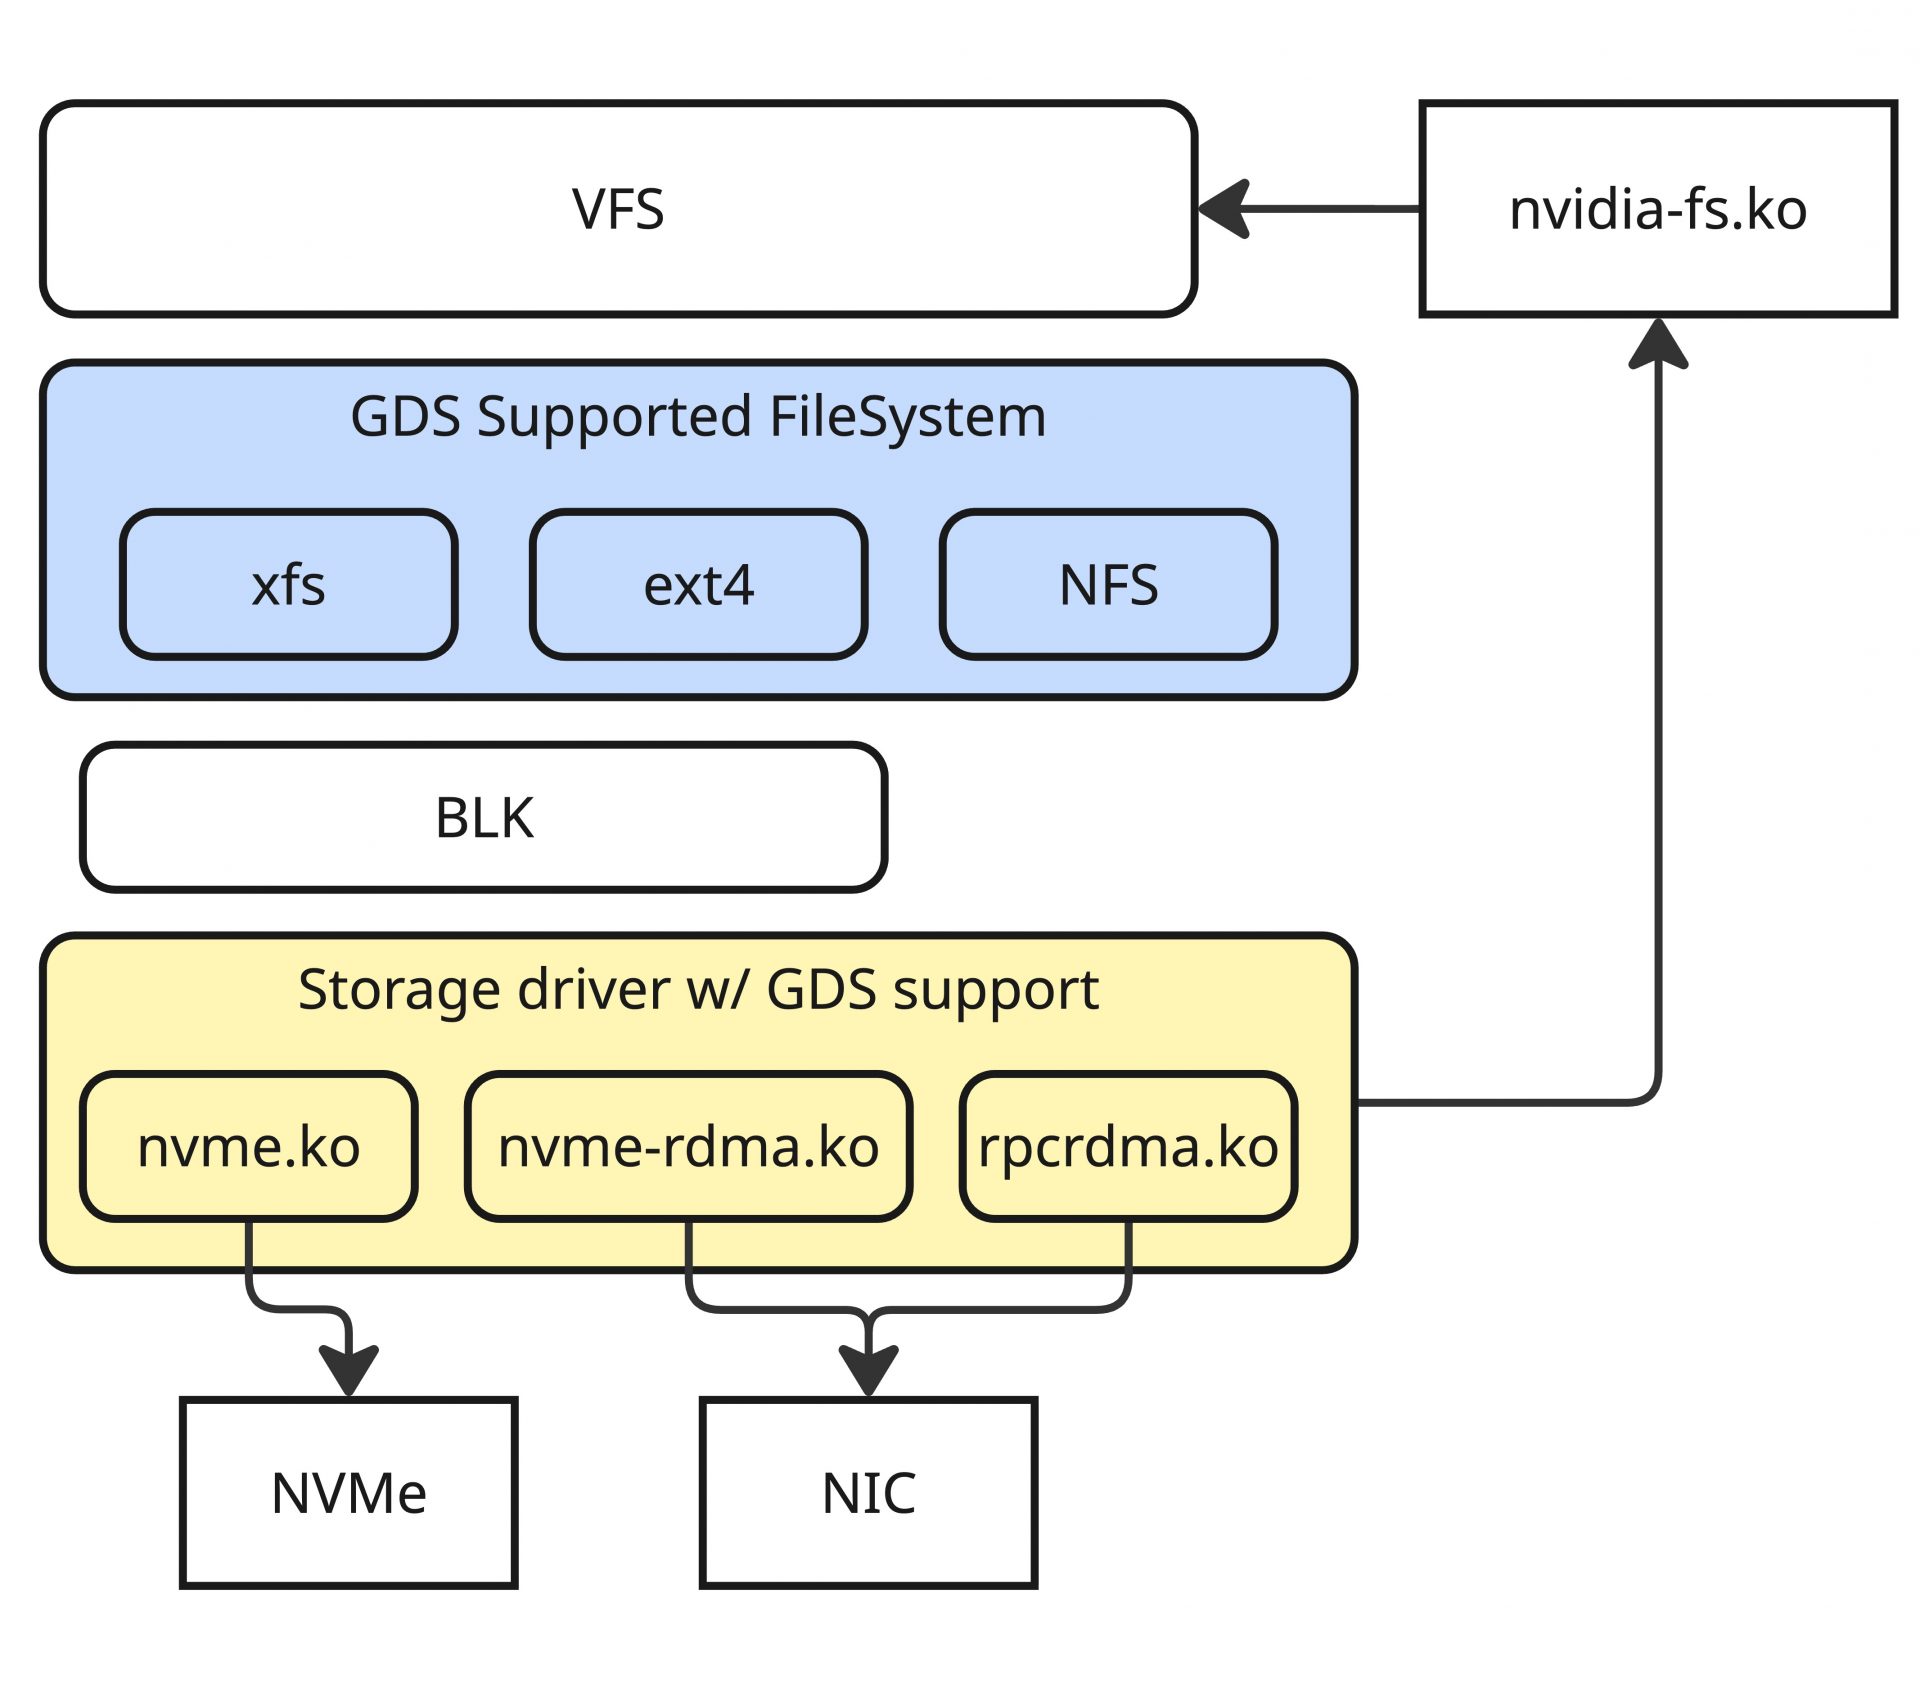
処理の流れとしては、nvidia-fs.koがmodprobeされるタイミングで自身のコールバック関数群を各ドライバーに登録し、ドライバー側はI/Oの処理の中でこのコールバックを呼び出す、という形になります。nvidia-fs.koは、/dev/nvidia-fs*がopenされたタイミングで、GDS対応ドライバーがエクスポートする登録関数(nvme_v1_register_nvfs_dma_opsなど)を探し、自身のコールバック群(struct nvfs_dma_rw_ops)を渡して登録します。そして、コールバックが呼び出されると、その処理の中でnvidia-fs.koがnv-p2p APIを用いてGPUページの認識と対応づけを行います。
本記事における処理フローは、基本的にUbuntu 24.04(Linux 6.8)での実装に基づいて説明しています。Linux 6.17以降(Ubuntu 26.04はこちらに該当)では、ブロックレイヤーのDMAマッピングがDMA Iterator方式に変わり、
nvme.koから呼ばれるコールバックも異なるもの(struct nvfs_dma_rw_blk_iter_ops)に置き換わっています。
以上の概要をもとに、Local GDSとRemote GDSについて処理の詳細について深掘りしていきます。なお、以降の内容はMLNX_OFED 26.04の内容に基づきます。
Local GDS(NVMe)の詳細
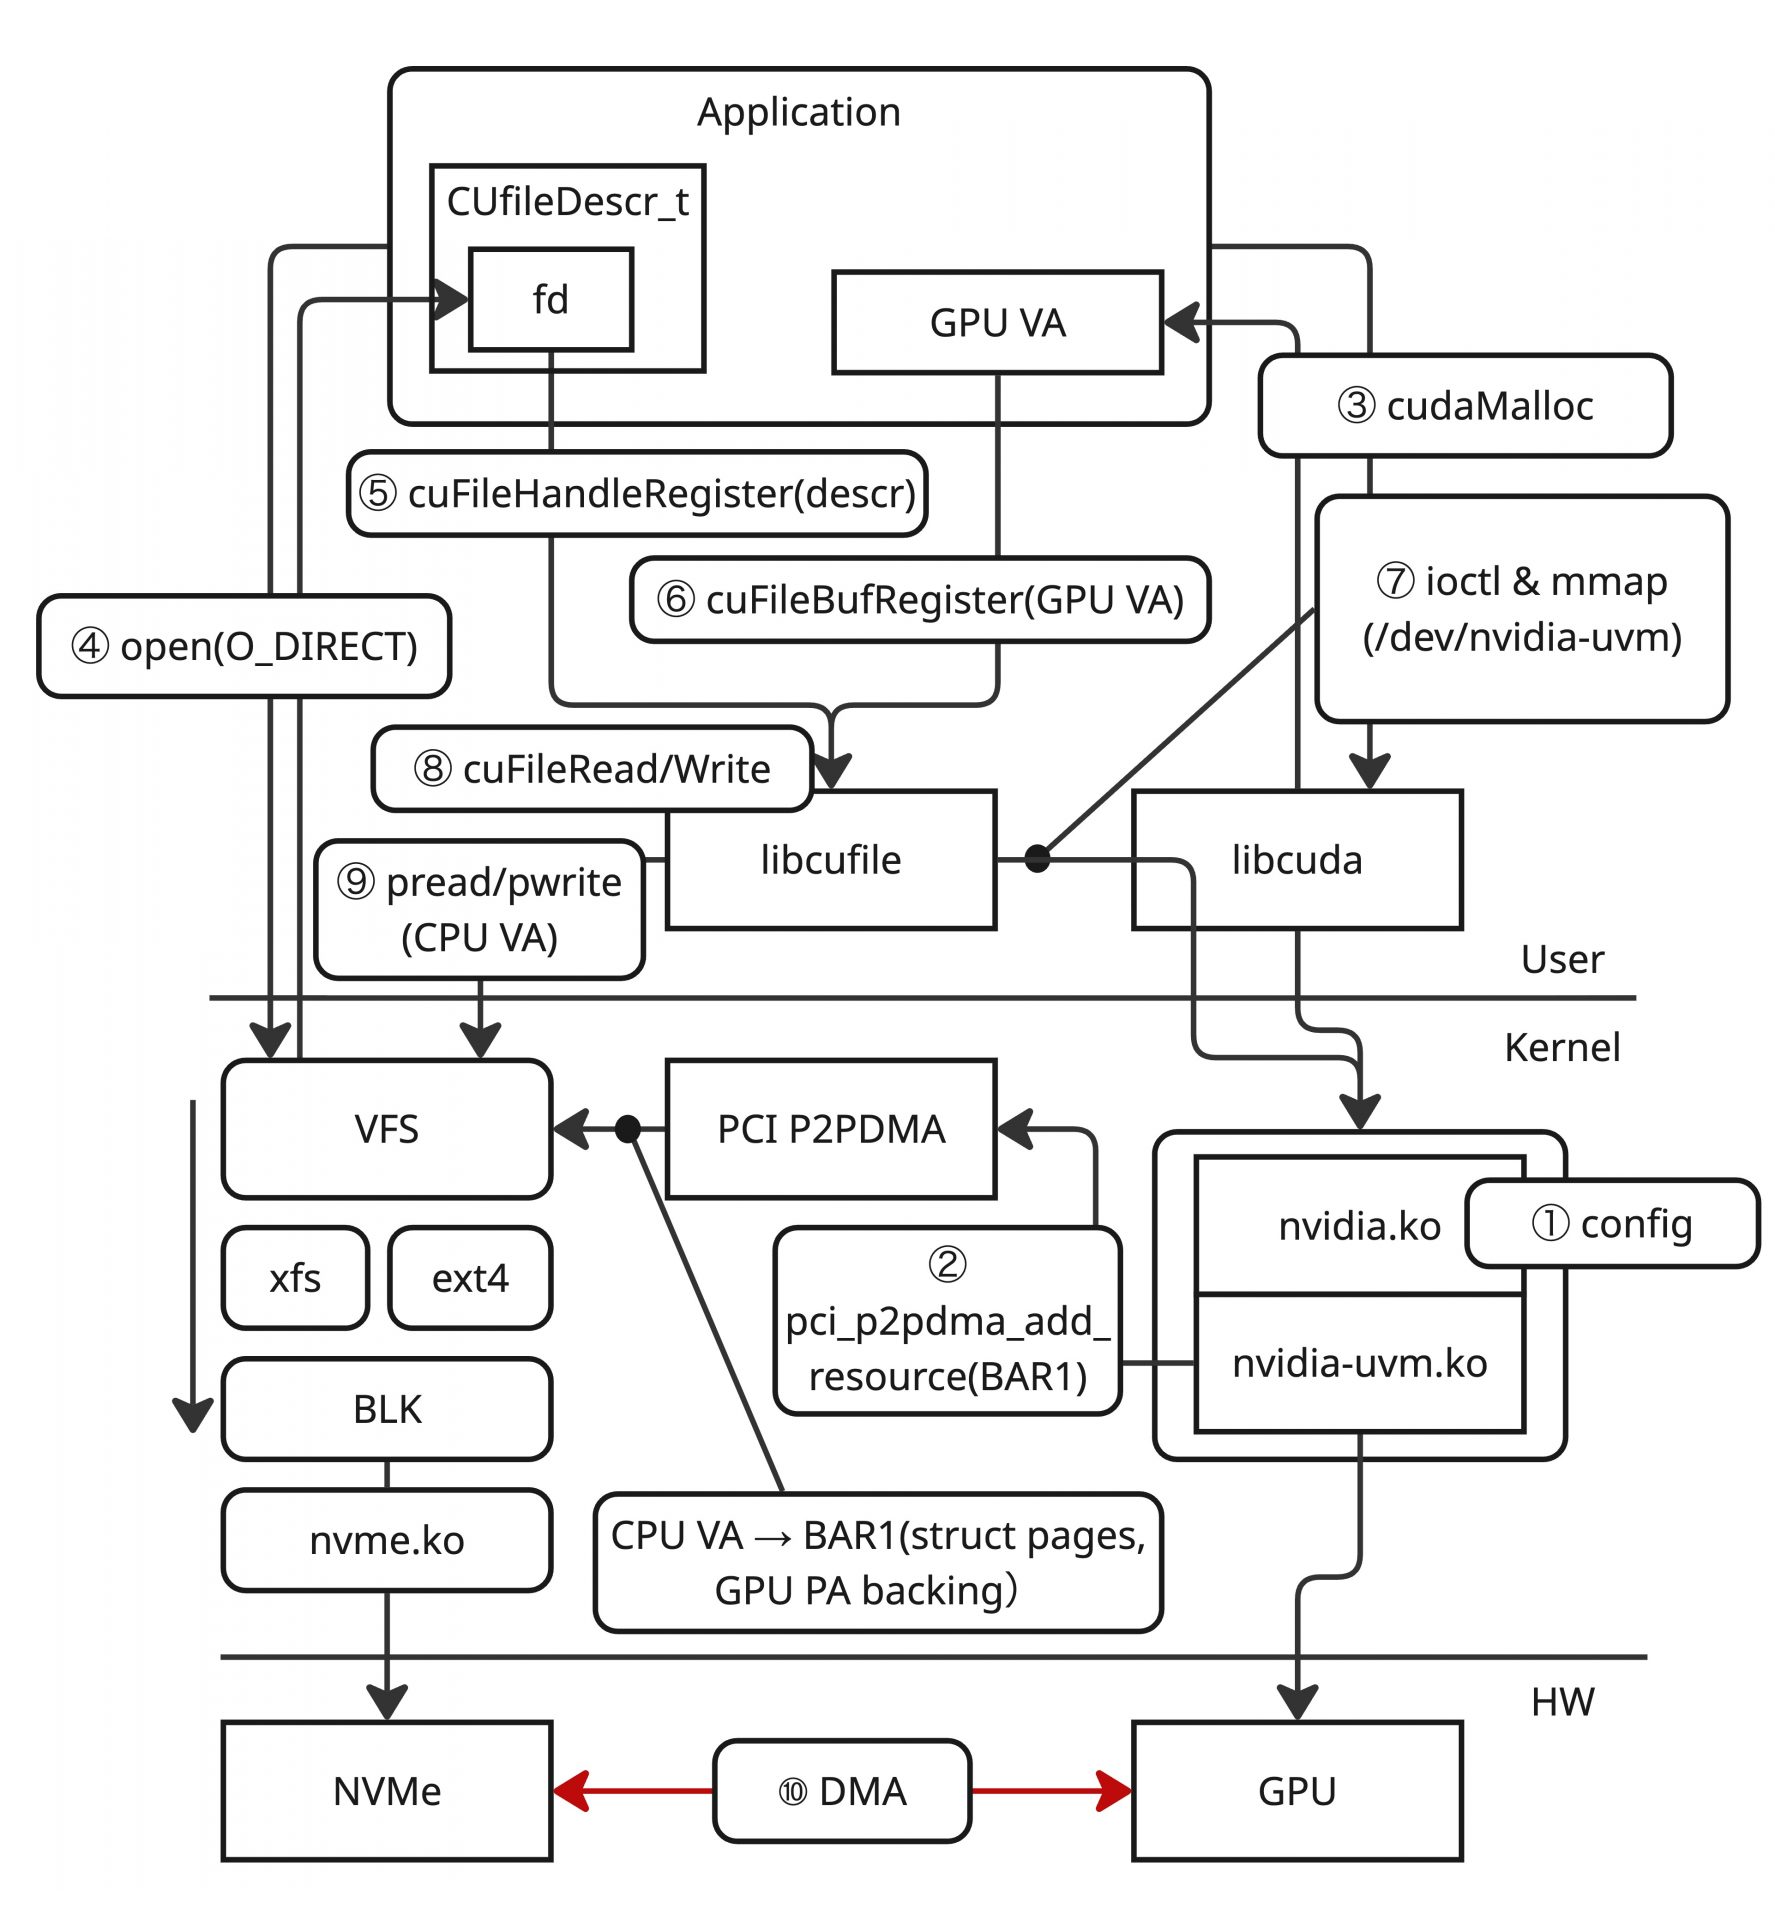
Local NVMeにおけるGDSの処理の流れは大まかには次のようになります。
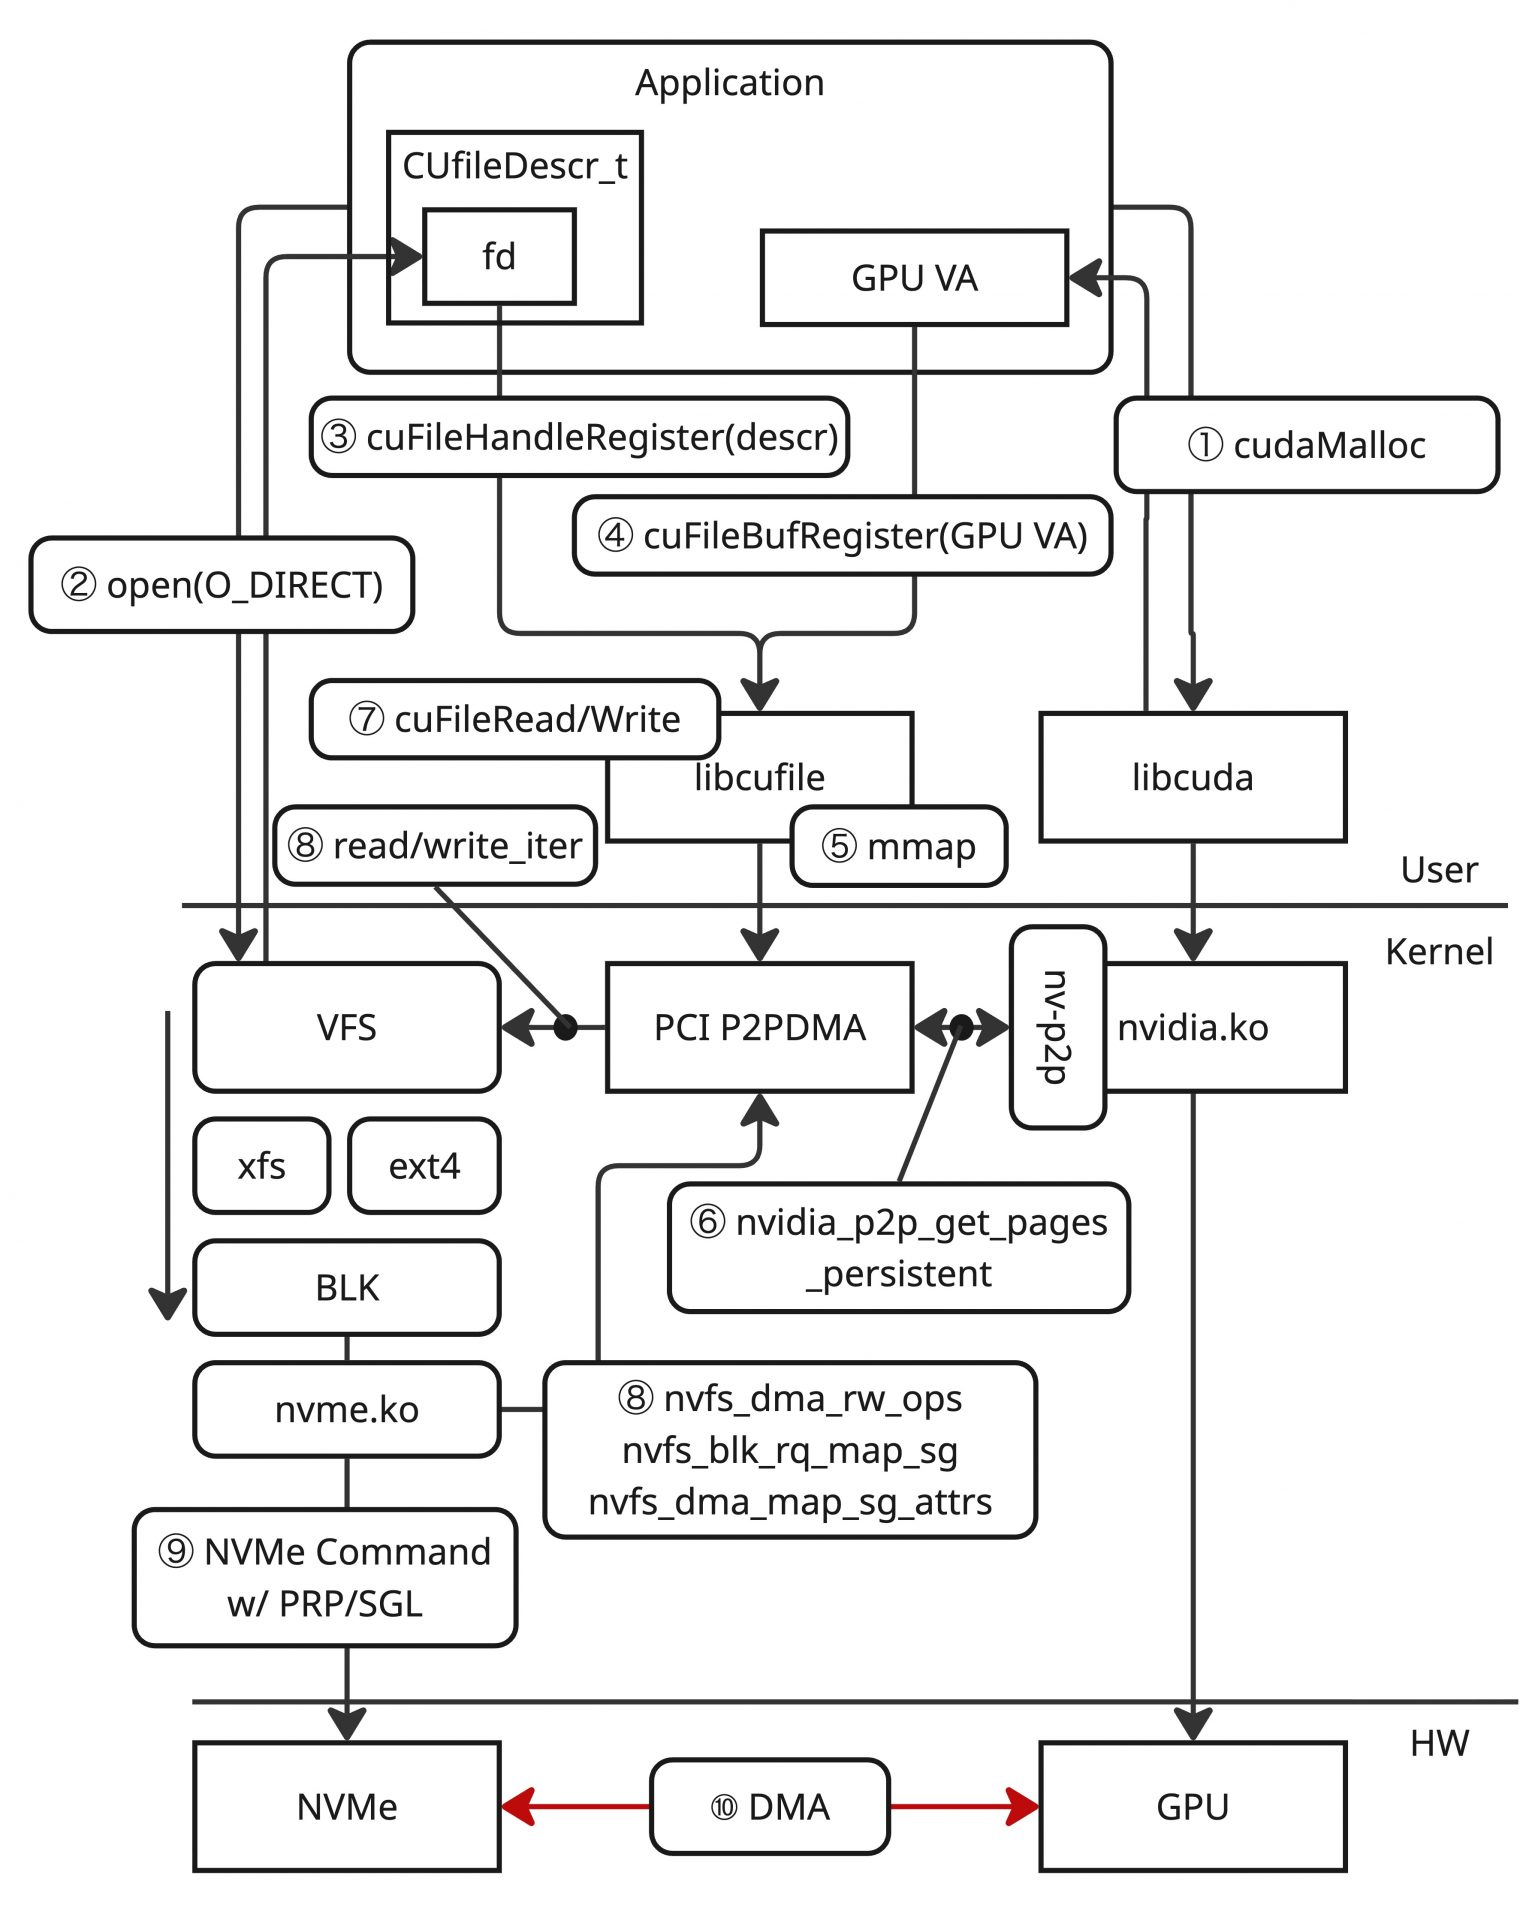
上記の図中の番号に沿って簡単に解説していきます。処理の内容としてはおおまかに準備段階(1〜6)とI/O処理段階(7〜11)と整理すると良いです。
- cudaMallocなどでGPUメモリーを確保し、GPU VAを得る
- open(O_DIRECT)でファイルを開き、ファイルディスクリプタを得る
- これを
CUfileDescr_tでラップし、cuFileHandleRegisterでcuFileに登録しハンドルを得る cuFileBufRegister(GPU VA)でバッファをcuFileに登録する(必須ではない)- 4の処理の流れで、libcufileは
/dev/nvidia-fs*にmmapを発行し、後ほどDMA時にGPUアドレスへ差し替えるためのshadow bufferを確保 - 5で確保した
shadow bufferとGPU VAの対応を/dev/nvidia-fs*へのioctl経由でnvidia-fs.koに伝え、nvidia_p2p_get_pages_persistentによりGPUページをピン留め・物理ページ表を取得し、shadow bufferと紐づける cuFileRead/cuFileWrite(handle, GPU VA, ...)の呼び出しによって、ioctl経由でカーネル内部のI/O処理に移るnvidia-fs.koは、shadow bufferのCPU VAを利用して、カーネル内部からread_iter/write_iterを呼び出す- VFS・ファイルシステム・ブロックレイヤーを経てリクエストが
nvme.koに届くと、nvme.koは自身に登録されているnvidia-fs.koのコールバック(struct nvfs_dma_rw_ops)を呼び出す。nvfs_blk_rq_map_sgでGPUページを含むI/Oと判定された場合は、nvfs_dma_map_sg_attrsでshadow bufferのページをGPUのバスアドレスへ差し替える(CPUページのみの場合は通常のDMA処理に戻る) - 差し替えられたバスアドレスでPRP/SGLを組み、NVMeコマンドを発行する
- NVMeコントローラーのDMAエンジンがデータ転送を処理する
cuFileBufRegisterの明示的な呼び出しは任意であり、呼び出した場合は、その時点でユーザーのGPUバッファに対して5、6の処理が実行されると想定されます。明示的に呼び出さない場合は、cuFileRead/cuFileWriteの呼び出しを契機に5、6に関わる処理が実施されることが、公式ドキュメントから推察されます。
これをみると分かる通り、GDSを成立させるためには、nvidia-fs.koのモジュールロード以外にも、前述したGDS対応版の対象ストレージ向けのデバイスドライバー(nvme.koなど)がロードされている必要があります。仮にこれがロードされていない場合は、意図的に設定で無効化していない限り、後述の「互換モード(Compatibility Mode)」にフォールバックします。このロジックはlibcufile側の実装であり、クローズドソースのためコードレベルでは確認できていませんが、公式資料からPOSIXのpread/pwrite/aio_submitを利用することが読み取れます。
Remote GDS(NVMe-oF)の詳細
次に、Remote GDSについて、NVMe-oFの場合を例にとります。NVMe-oFのイニシエーター側を担うのはnvme-rdma.koで、これもmlnx-nvmeパッケージに含まれており、nvme.koと同様にGDS対応フックが組み込まれています。
基本的な構造はLocal NVMeと酷似しており、実際のコード上のロジックもほぼ同じであるため、図中の詳細は省略しています。ただし、nvme-rdma.koからは、ネットワーク越しの通信を成立させるために、ネットワーク向けのドライバー(RDMAの場合は、ib_core)と連携し、最終的にはNICを経由してパケットとしてデータを転送しなければなりません。
この違いはnvidia-fs.koのコールバック呼び出し方に現れます。nvfs_dma_map_sg_attrsではマップ先のデバイスを引数として取るのですが、Local NVMeの場合はNVMeコントローラーの情報を渡していたこの引数に、NIC(HCA)の情報を渡します。これによって、GPUページはNICから直接DMA可能なアドレスにマップされます。そのアドレスを利用して、RDMAのためのMemory Regionの構築などを進めます。RDMA READ/WRITEの対象領域がそのままGPUメモリーになるため、結果としてGDRと同種のデータ転送がNetwork越しに実現されるわけです。
面白いのは、最終的に行われるデータ転送(GPUとNIC間のP2P DMA)はGDRと同じになるものの、そこに至るまでの過程がGDRとは異なるという点です。GDRの場合は、以前説明した通り、ユーザースペース(libibverbs)からのリクエストを起点に、Peer Memory Clientやdma-bufなどの仕組みで、MR登録のタイミングでGPUメモリーがマップされ、事前登録されたMRを使って転送が実行されます。一方、GDSの場合は、nvme-rdmaドライバーーが、ブロックレイヤーから受け取ったリクエストを送信するたびにscatter-gatherのDMAマップとMRの登録を行い、完了時にそれらを解除します。なお、GPUメモリーをNIC向けにP2Pマップする処理自体は、GPUバッファとNICの組ごとに初回だけ行われ、nvidia-fs.ko内でキャッシュされます。つまり「ユーザースペース起点・事前登録したMRを使う」GDRに対して、GDSは「カーネル内・I/Oリクエストごとにマップ/登録する」形で同じ物理転送を成立させている、と言えます。
今回の紹介はNVMeの延長としてNVMe-oFを取り扱いましたが、実際はNFS over RDMAなど他にも有力な選択肢があり、これらはまた別のドライバー(rpcrdmaなど)が関与し、専用の実装が存在しています。ただし、基本的なエッセンスはここまでで確認してきたものと概ね同じで、それをうまく各種プロトコルに実装しています。
PCI P2PDMAを用いたLinux kernelの実装
さて、ここまでの議論ではNVIDIAが提供する仕組みによって実現される方式を紹介してきました。ここからは、GDRの説明を行った際と同様に、Linux kernelのUpstreamの実装について触れようと思います。
Upstreamのカーネルには、GDSのような転送を実現するための汎用的な仕組みとしてPCI P2PDMAが実装されており、GDS(libcufile)はこれを利用する動作モードを持っています。この動作モードは、設定で"use_pci_p2pdma": trueを指定することで有効になります。
まず、PCI P2PDMAですが、これはPCIデバイスがBARで公開しているデバイスメモリーに対して、ZONE_DEVICEの一種であるMEMORY_DEVICE_PCI_P2PDMA型のstruct pageを用意する機能です。Linuxカーネルでは、通常のユーザーバッファを扱うDirect I/Oの場合、GUP系の処理で取得したページを、ブロックレイヤーのbioやscatterlistを通じて扱います。そのため、本来struct pageを持たないデバイスメモリーは、こうしたページベースのI/O経路にそのまま渡すことができませんでした。PCI P2PDMAはデバイスメモリーへstruct pageを与えることで、P2PDMA対応のI/O経路を通してデバイスメモリーを渡せるようにし、デバイス間のDMA転送を可能にしたわけです。
この仕組みによって比較的自然にVFSと連携できるようになり、DMAアドレスの対応付けもカーネル標準のPCI P2PDMAとDMA APIが担うようになりました。そのため、nvidia-fs.koおよびその連携パッチを組み込んだNVMeドライバー(mlnx-nvmeなど)の依存を外せます。一方で、libcufileと、後述の設定を施したNVIDIAのオープンソース版のGPU Driverは引き続き必要です。
ここではまた処理フローの概要を通じて整理していきましょう。
PCI P2PDMAを用いたLocal GDSは、概ね次のような処理フローになります。
nvidia.koのロード時にRMForceStaticBar1=1で静的BAR1を強制し、RmForceDisableIomapWC=1でBAR1をUncached属性でマップするnvidia-uvm.koがGPUを初期化する際、静的BAR1が有効で、かつWCでマップされていない場合に限り、pci_p2pdma_add_resourceでBAR1全体をZONE_DEVICEのstruct pageとして登録する- cudaMallocなどでGPUメモリーを確保し、GPU VAを得る(この割り当てを識別するRMのハンドルはおそらくlibcudaが保持)
open(O_DIRECT)でファイルを開き、ファイルディスクリプタを得る- これを
CUfileDescr_tでラップし、cuFileHandleRegisterでcuFileに登録しハンドルを得る cuFileBufRegister(GPU VA)でバッファをcuFileに登録する(必須ではない)- GPUバッファに対応するBAR1上のP2PDMAページを、
nvidia-uvm.koを介してユーザースペースにマップしCPU VAを得る。これは二段階の手続きによって実現されている。まず/dev/nvidia-uvmへのioctlに、RMのハンドルとマップ先のCPU VAを渡して、対応するBAR1上のページを登録する。次に、同じアドレスでmmapすることで、そのページがプロセスのページテーブルに挿入される cuFileRead/cuFileWrite(handle, GPU VA, ...)を、アプリケーションから発行する(I/O処理の開始)- libcufileからVFSに、7で得たCPU VAを利用してユーザースペースからI/Oを発行する
- VFS(Direct I/O)では、GUP(
pin_user_pages_fast)でBAR1上のP2PDMAページが取得され、NVMeドライバーがBAR1のアドレスをDMAアドレスとして使い、GPUメモリーと直接転送する
この方式の場合ではnvidia-fs.koが介在しなくなるため、内部の処理は変わりますが、ユーザーアプリケーションから実施する呼び出しは基本的には同じです。
上記の手順のうち1、2、7について、少し補足を加えておきます。この補足はかなり踏み込んだ議論になっているため、読み飛ばしても問題ありません。
PCI P2PDMAを利用する場合は、NVIDIA Open Driverが必要です。また、nvidia.koの読み込み時にRMForceStaticBar1=1およびRmForceDisableIomapWC=1のパラメーターを設定します。大雑把に説明すると、前者はNVIDIA Resource Manager(RM)に、BAR1がGPUメモリー全体を線形・固定でマッピングするように構成させる設定で、全GPUメモリーに対応するP2PDMAページを用意するために必要です。後者はBAR1のデフォルトのWrite Combine(WC)属性を無効にし、Uncached属性でマッピングさせる設定です。これは現在のLinuxカーネルの制約により、BAR1がすでにWCでマップされているとP2PDMAページを作成できないためです。nvidia-uvm.koはWCが有効な場合、P2PDMAページの登録自体を行いません。いずれも、NVIDIAドライバーがBAR1を経由してGPUメモリーをP2PDMAページとして提供するこの方式で必要となる設定です。設定方法については公式のSetting the Driver Registries for Enabling PCI P2PDMAを参照してください。
手順7のioctlには、GPU VAではなく、GPUメモリーを識別するRMのハンドルを渡しています。このハンドルを保持しているのはおそらくlibcudaであるため、libcufileがlibcudaと連携し、libcuda側から発行されていると考えられますが、いずれもクローズドソースのため断定はできません。またこの処理は、自然に考えればcuFileBufRegisterで明示的にバッファを登録した時点で実施されるか、これを呼び出さない場合は初回のcuFileRead/cuFileWriteの際に行われると想定されます。気になる方は、bpftraceなどで/dev/nvidia-uvmへのioctlや、nvidia-uvm.ko内の該当関数(uvm_api_alloc_device_p2pなど)にフックを掛け、呼び出し時のユーザースペースのスタックを確認してみると面白いかもしれません。
本稿執筆時点では、旧来の方法とPCI P2PDMAのどちらが良いかを明確に言い切ることは難しいです。PCI P2PDMAの実装も十分に整備されていますが、カーネルのバージョンの要求があります。しかしこちらを採用できると、NVIDIA GPUに関連する複雑な依存の一部を解消できます。その一方で、実は一部機能が足りていない部分などもあるため、場合によっては旧来の方式を採用する方が望ましいケースもあるかもしれません。現状、将来的にどうなるかはまだ不透明ですが、Upstream化を進めている動きがあることからも、時が経つとともにnvidia-fs.koを利用する世界観は薄れ、PCI P2PDMAをベースにする方式が一般的になってくる可能性はあり得るでしょう。これらを総合的に考慮した上で、それぞれの環境に即した方式を選択することが求められます。
PCIe TopologyとDynamic Routing、および Compatibility Mode
本章の序盤、「GDSは必ずしもGPUとストレージ間の直接的なデータ転送を行うわけではない」という旨を記載しましたが、この点について最後に整理しようと思います。ここでは説明の都合上、分かりやすくするためにRemote GDSを取り扱います。
Remote GDSの場合、これまでの説明から明確な通り、クライアント側は基本的にGPUとストレージ用のNICの間でのDMA転送になります。ただ、このDMAの性能はPCIe Topology上のどの経路を辿るかによって変化します。パフォーマンスに影響が出る典型的な構成差分として、同一のRoot Portを共有しているか否かがまず挙げられます。
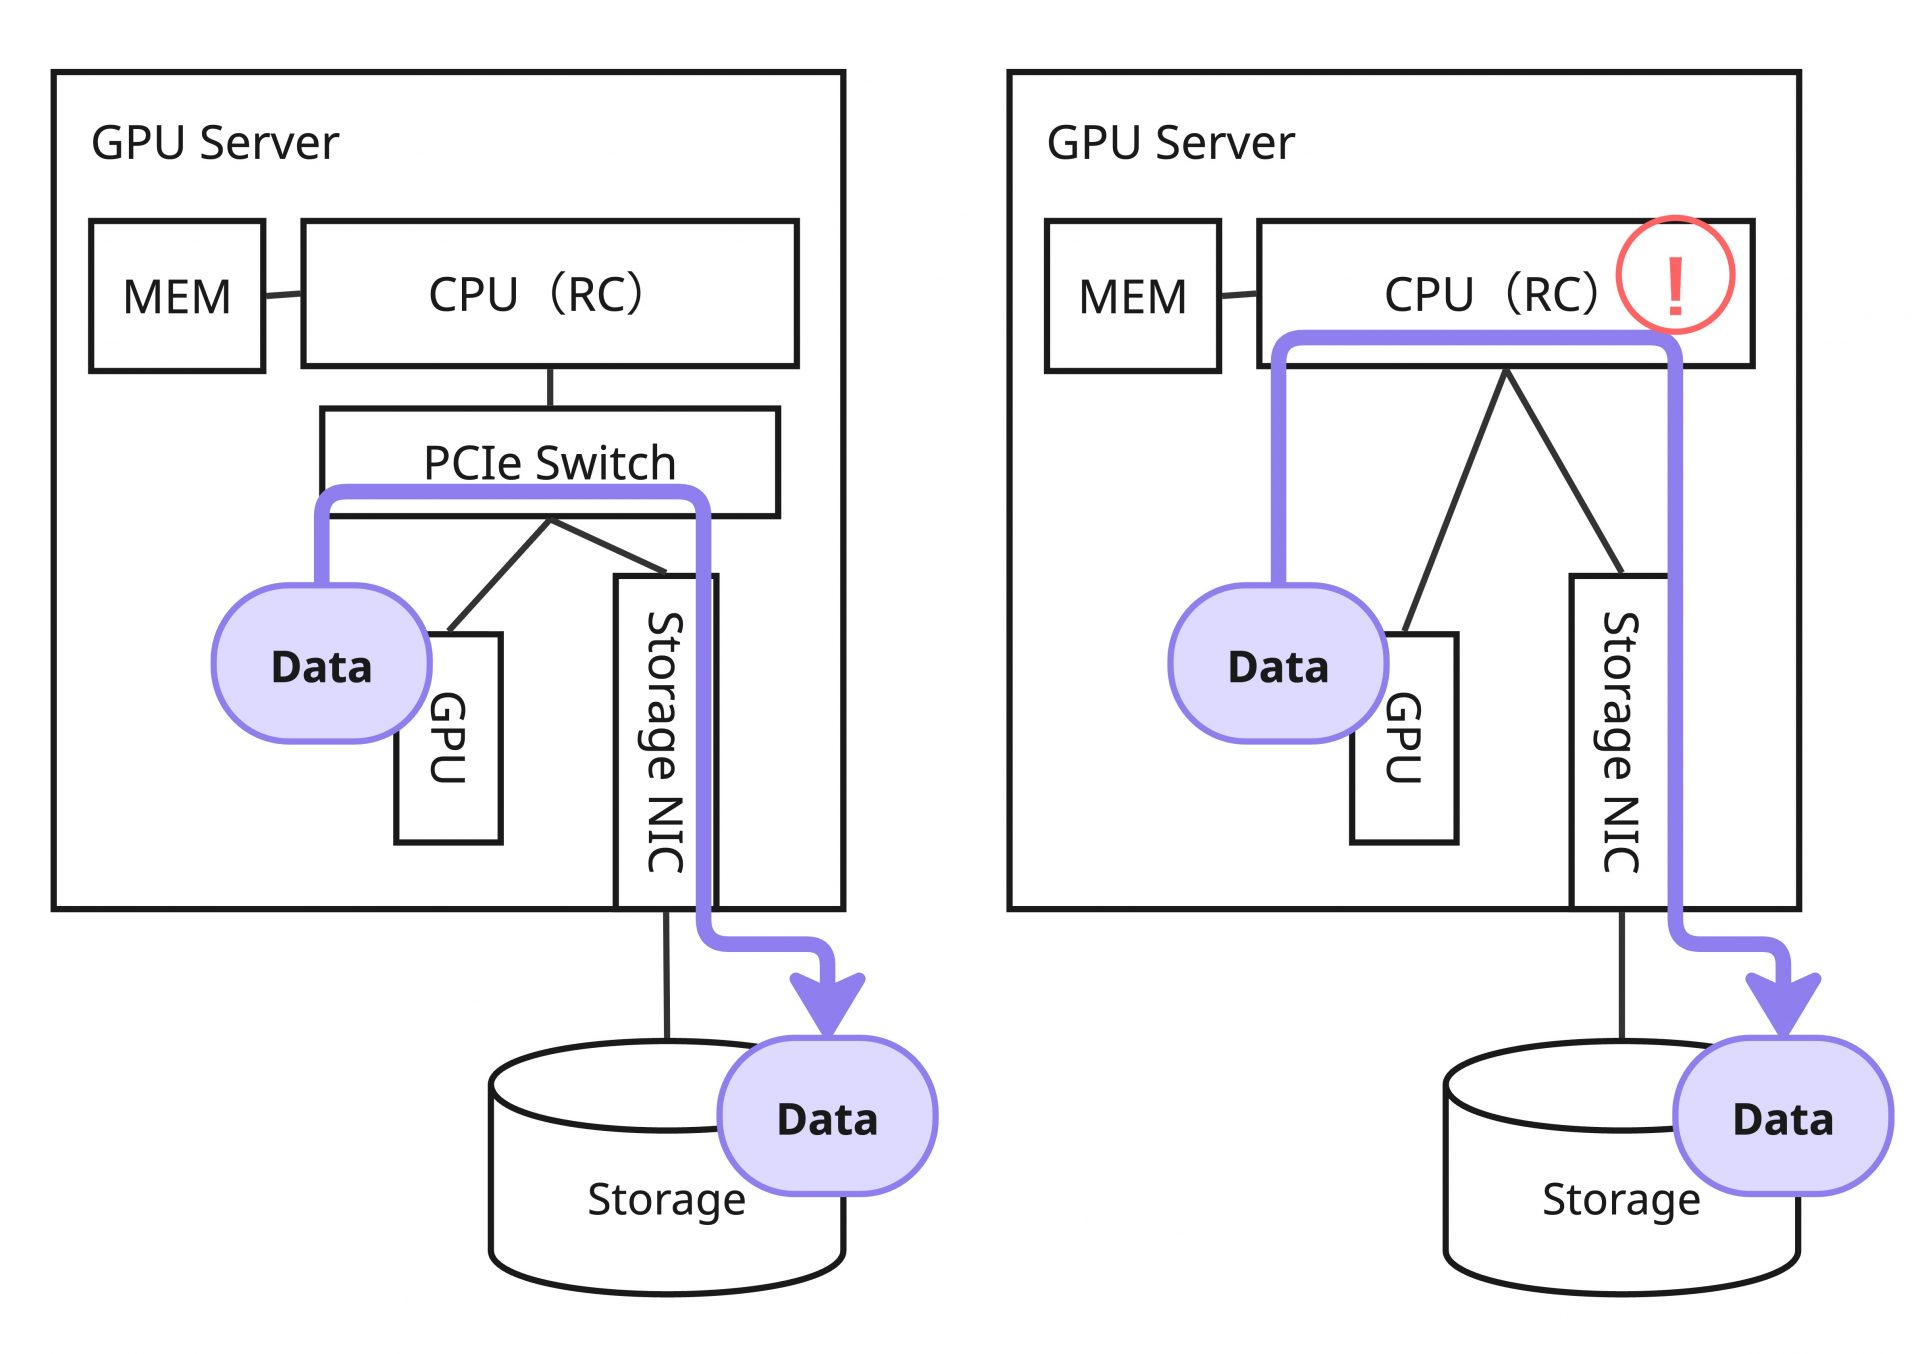
上図の左は同一のRoot Portを共有しているケース、右はRoot Portが異なるケースです。同一Root Port配下の場合は、適切にプラットフォームのI/O設定を行うことで(IOMMUの無効や、ACSの無効)PCIe Switchでトランザクションを折り返すことが可能になり、非常に良い性能のデバイス間P2P通信を実現できます。一方で右の場合はPCIeのトランザクションがCPU内部を経由するため、CPUのオンダイ・インターコネクトを通り、改めて別のRoot Portへ向かう形になり、追加のパフォーマンスペナルティが発生します。また、Root Port間のP2P forwardingはPCIe仕様上必須ではなく、対応可否や性能はプラットフォームの実装に依存します。そのため、この部分はソフトウェア側での実装として回避策を講じているケース(DRAMをバウンスバッファとして利用するケースや、後述の仕組み)があります。
もちろん、これ以外にもマルチソケットシステムの場合は、ソケット間通信を跨ぐとさらにペナルティが発生することもあります。
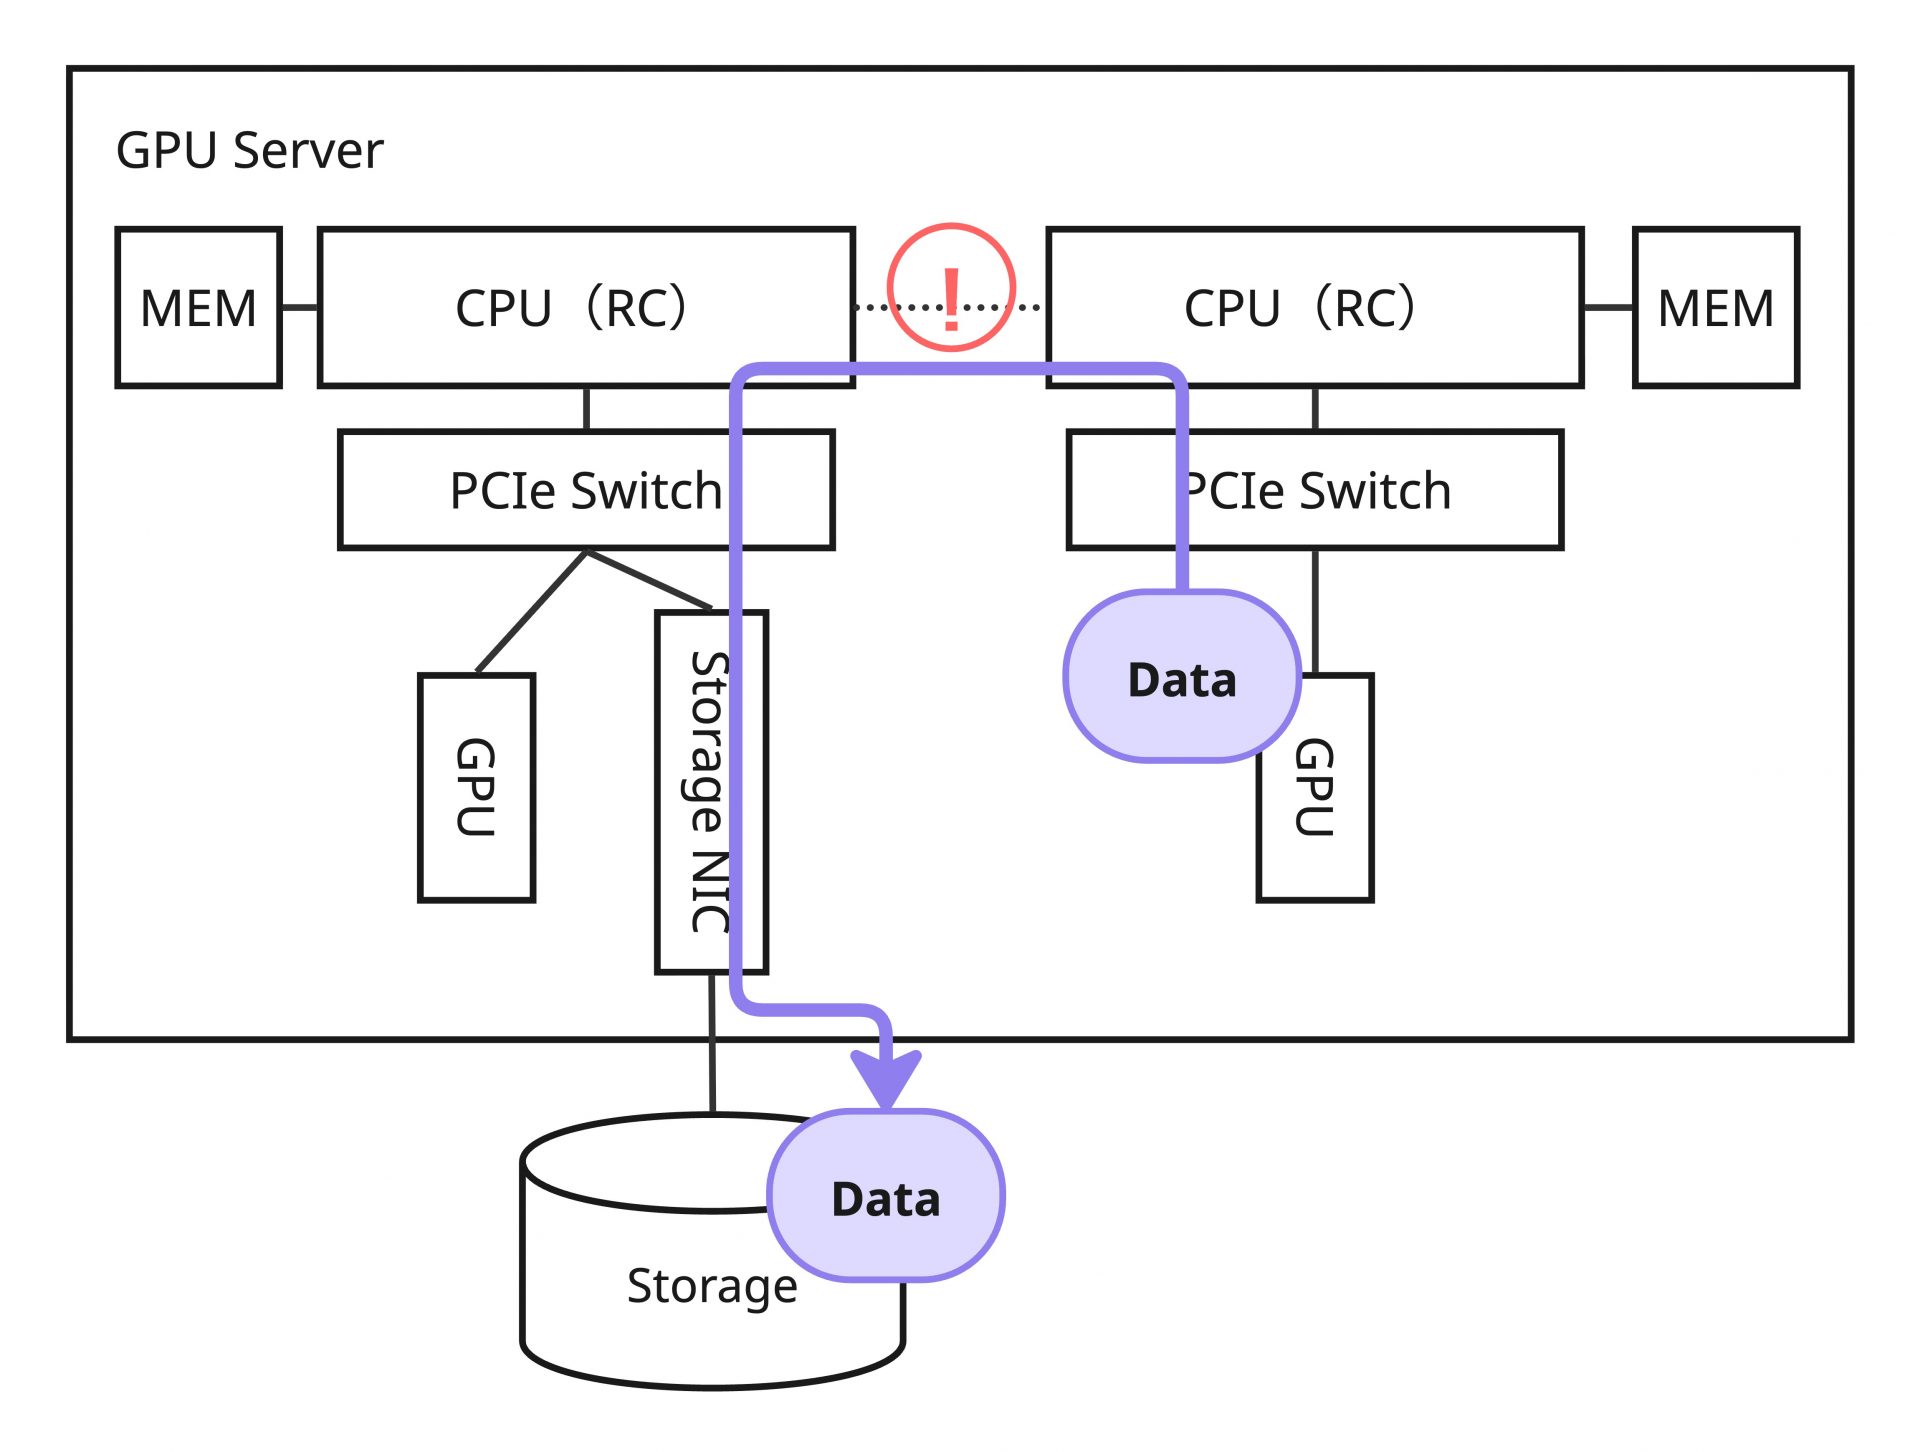
これらはサーバーの構成で決まる設計変数であるため、ソフトウェアからすると性能上の制約がソフトウェアの領域外によってもたらされることになります。そのため、GDSではDynamic Routingという仕組みによって、異なるレイアウトのサーバーであっても可能な限り最大限の性能がでるようなソフトウェア上の実装を提供しています。
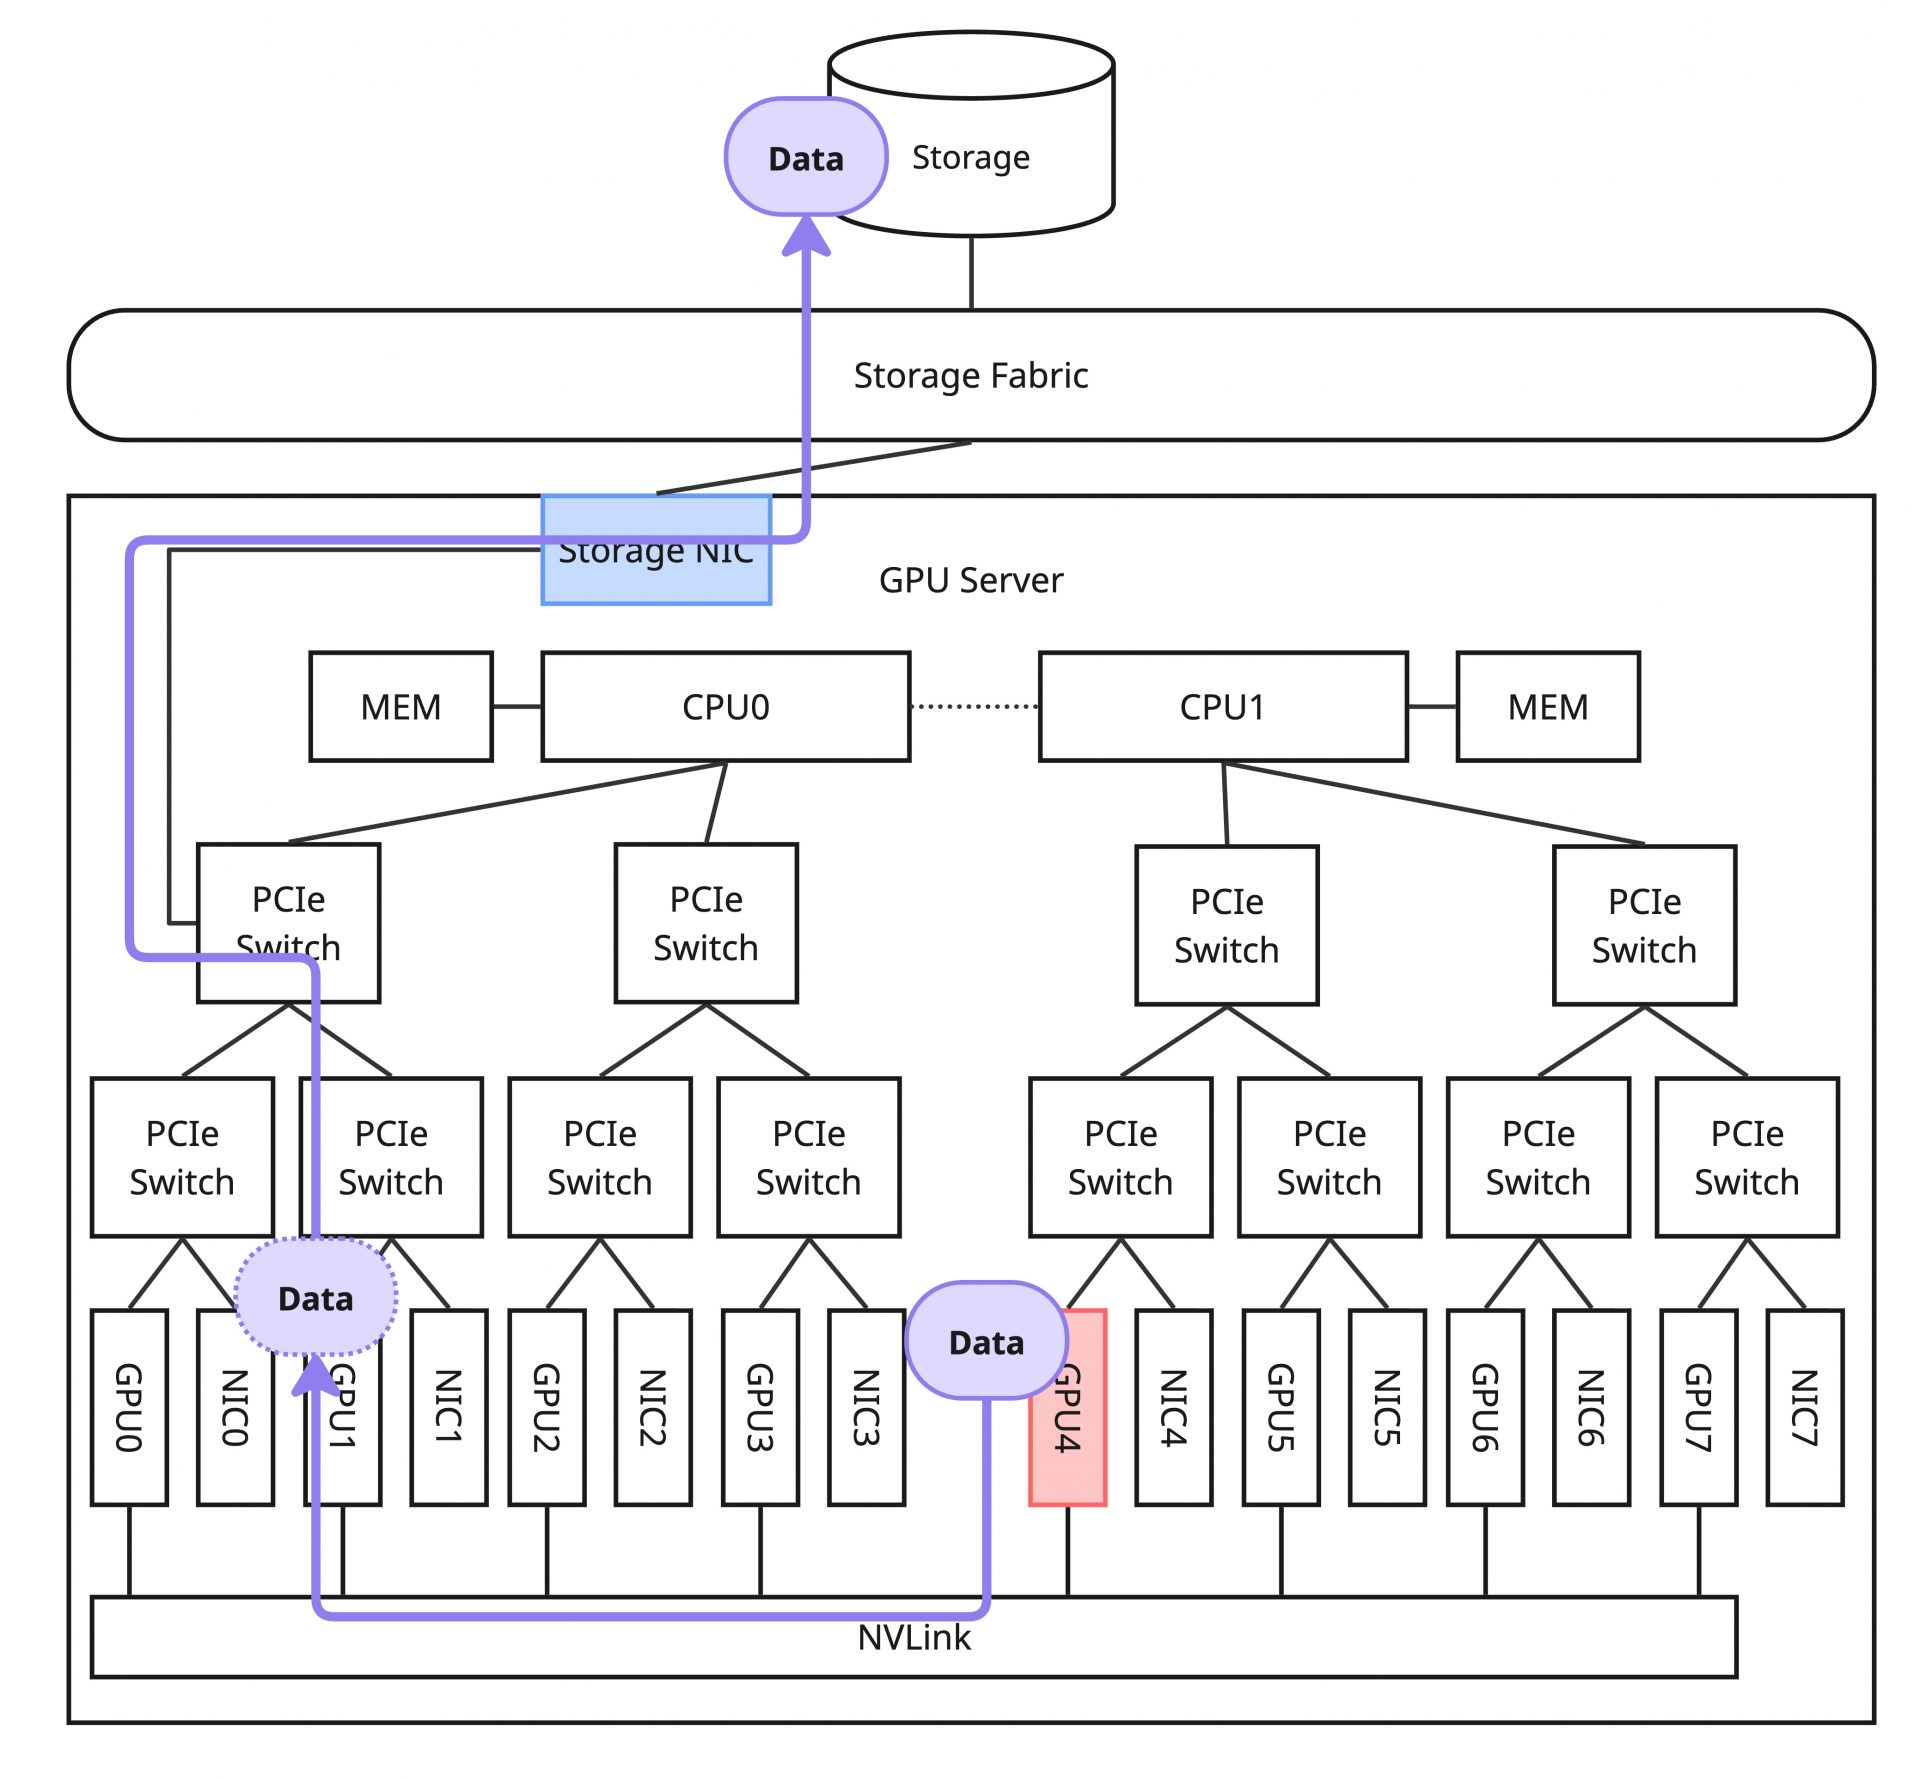
例えば下図のように、ストレージ用NICが目的のGPUとは異なる別のGPUとPCIe Switchで接続されており、かつGPU同士はNVLinkで接続されている構成としましょう。この場合、NVLinkを通してGPUを一時経由し、そこからPCIe Switchで折り返してストレージ用NICにデータを運ぶという経路を辿るのが最も効率的になります。これはDynamic Routingの設定でGPU_MEM_NVLINKSを有効にしていると実際に選択可能な経路になります。
また、例えばストレージ用NICが異なるCPU配下、かついずれのGPUともRoot Portを共有しない構成であって、GPU間はNVLinkが利用できるサーバーの場合、同一CPUドメインまではNVLinkで運び、その後NICにデータを送るということも実現されます。
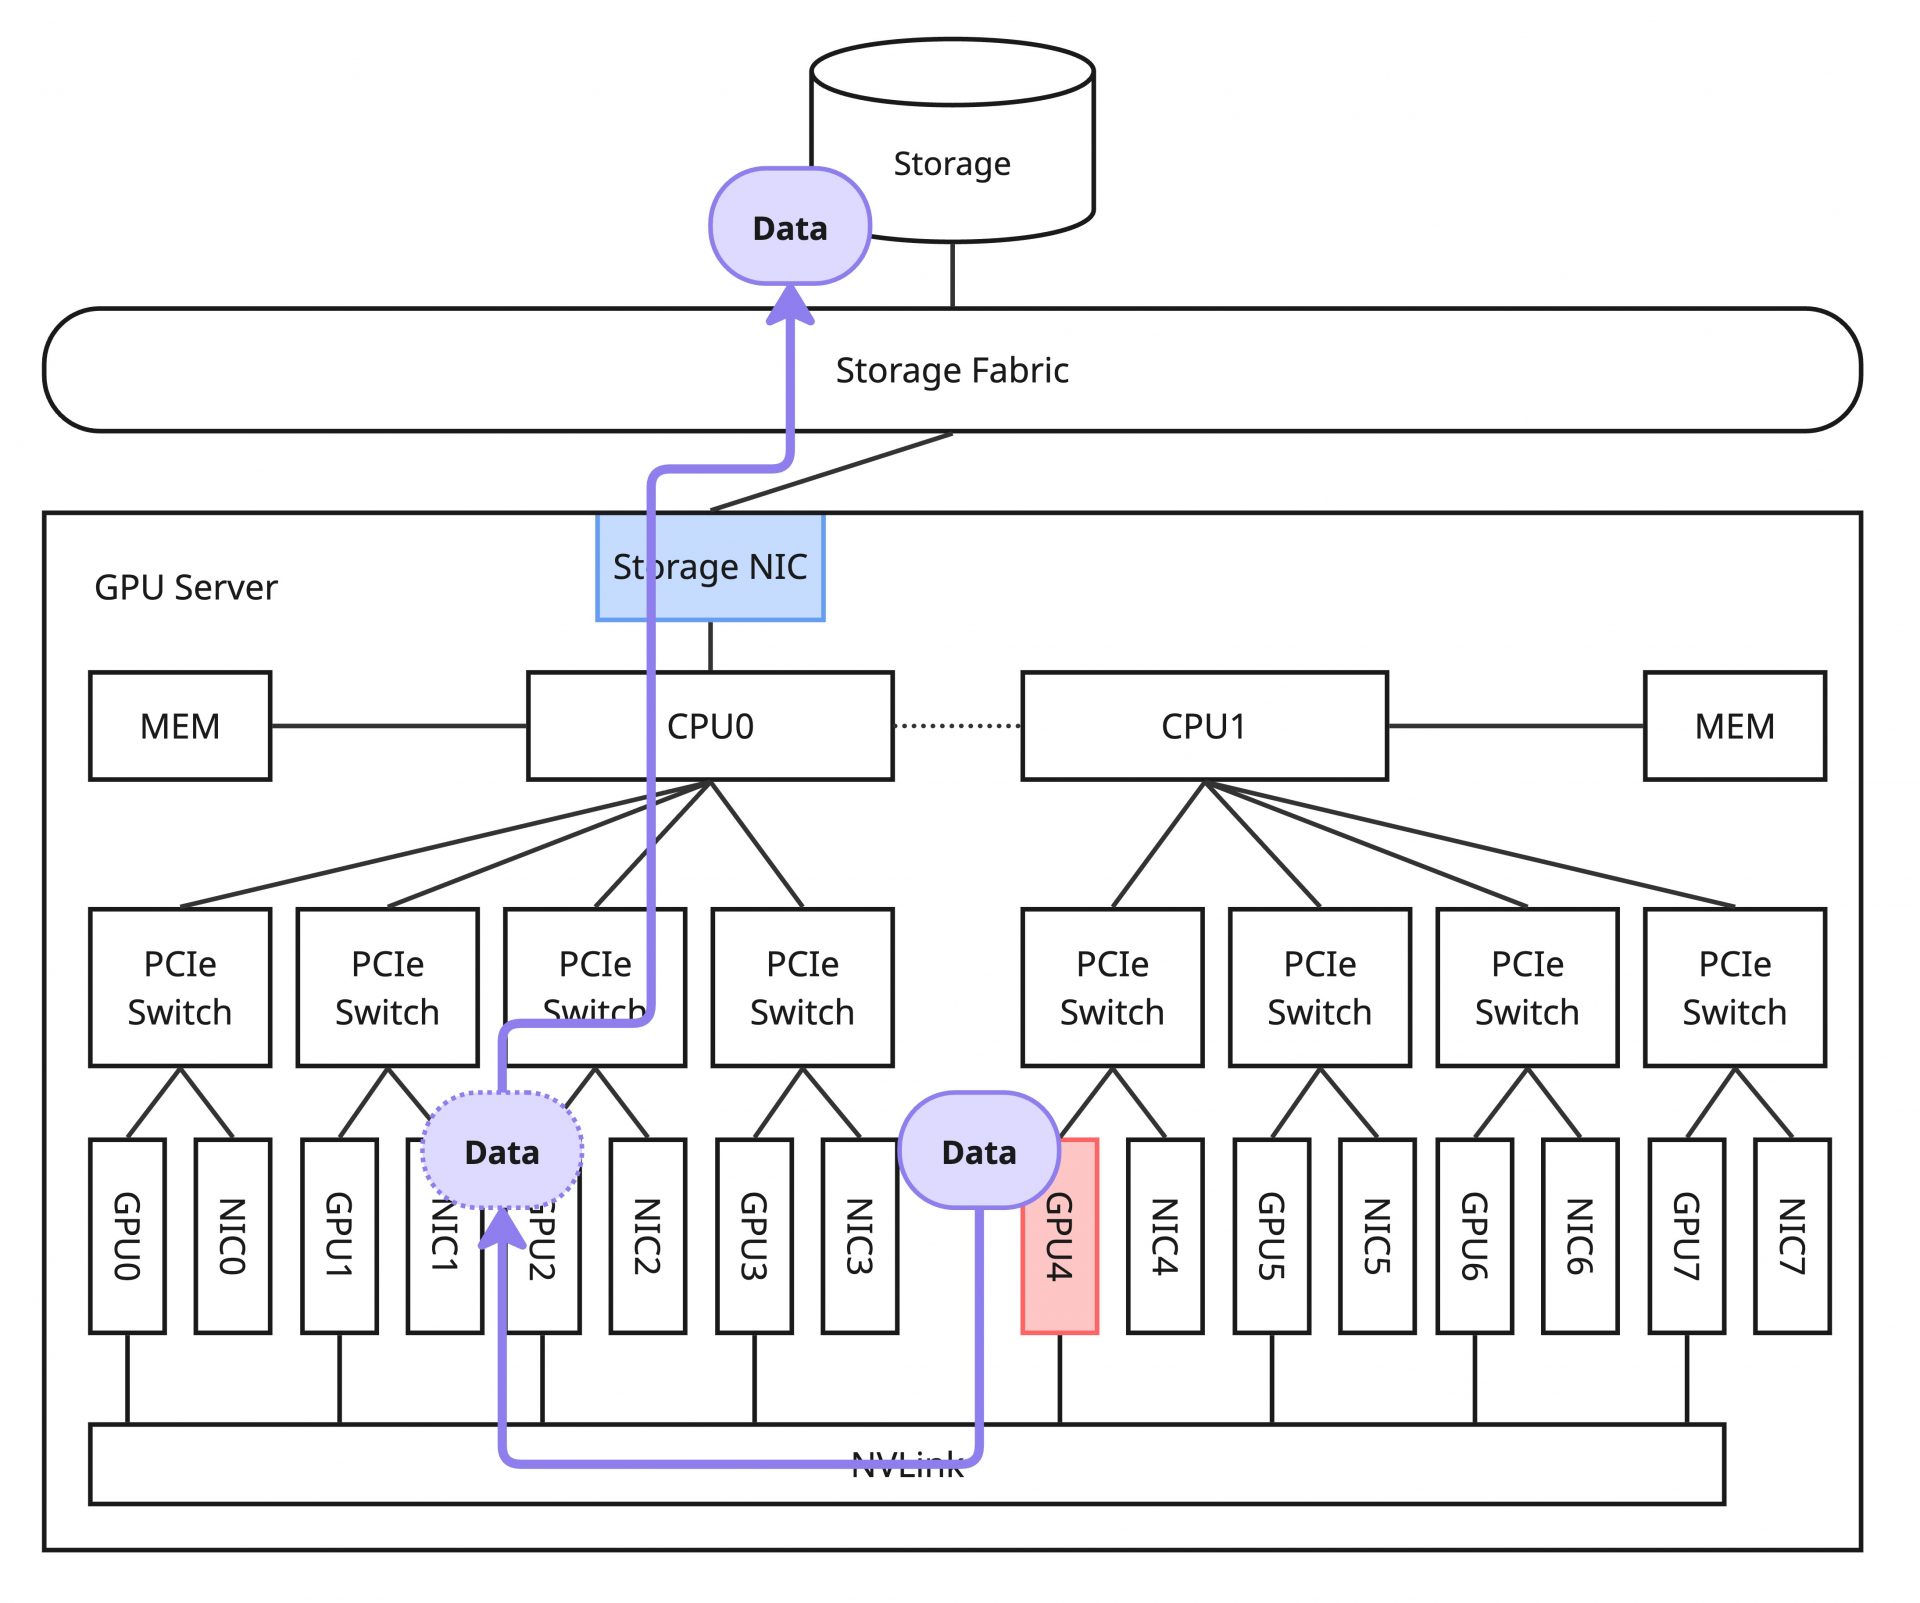
ただし上図の場合は前述した通り、CPUを経由するためRoot Port間のP2Pでの転送可否はプラットフォームに依存します。このとき、SYS_MEMを合わせて有効にしておくことで、DRAMをバウンスバッファとして利用する方式にフォールバックさせることが可能になります。他にもGPU_MEMという方式がありますが、基本的にNVLinkを搭載している場合はGPU_MEM_NVLINKSが優先されるためここでは省略とします。気になる方はドキュメントを参照してみてください。このように、Dynamic Routingはシステムのレイアウトにしたがった最適な経路選択によって、性能の最適化を狙ってくれます。
またこれらの経路選択の最適化以外にも、GDSが成立しない場合に通常のPOSIXの処理に切り替えるフォールバックパスとして、Compatibility Modeを提供しています。このCompatibility Modeによるフォールバックが作動するケースは、例えば操作しているディレクトリ(マウントポイント)がGDS-enabledではない場合や、NFSなどでRDMAが使えない場合など、色々と想定されます。
ここまでみてきた通り、GDSは本来サーバーレイアウトやユーザーの設定などに大きく依存する機能であるため、これらが意図していないような状況であっても動作自体は保証するような実装になっています。これは裏を返すと、GDSを利用する我々は環境に合った設定を行い、場合によってはGDSに適したPCIe Topologyを持つサーバーを選定することにより、ようやくGDSの効果を最大化できるということになります。これは利用者側の責務であり、今回GDSについて詳細に解説しようと考えた大きな理由です。
補足:Remote GDSはEnd-to-Endで直接転送になるか?
前述したRemote GDSの内容には実は不足している議論があります。それは、「本当にEnd-to-EndでStorageに直接書き込めているのか?」という点です。この補足ではこの部分についてもう一歩踏み込んで議論しますが、読み飛ばしても問題ありません。ここでは、先の議論の延長として話を進めると都合が良いので、NVMe-oFの場合を取り扱います。
NVMe-oFの場合、サーバー側でも通常はI/Oスタックを経由することになります。これは、パケットに包まれて飛んできたNVMeコマンドを解釈し、それをサーバー側のNVMeへ書き込むためのI/O処理を発行する必要があるためです。
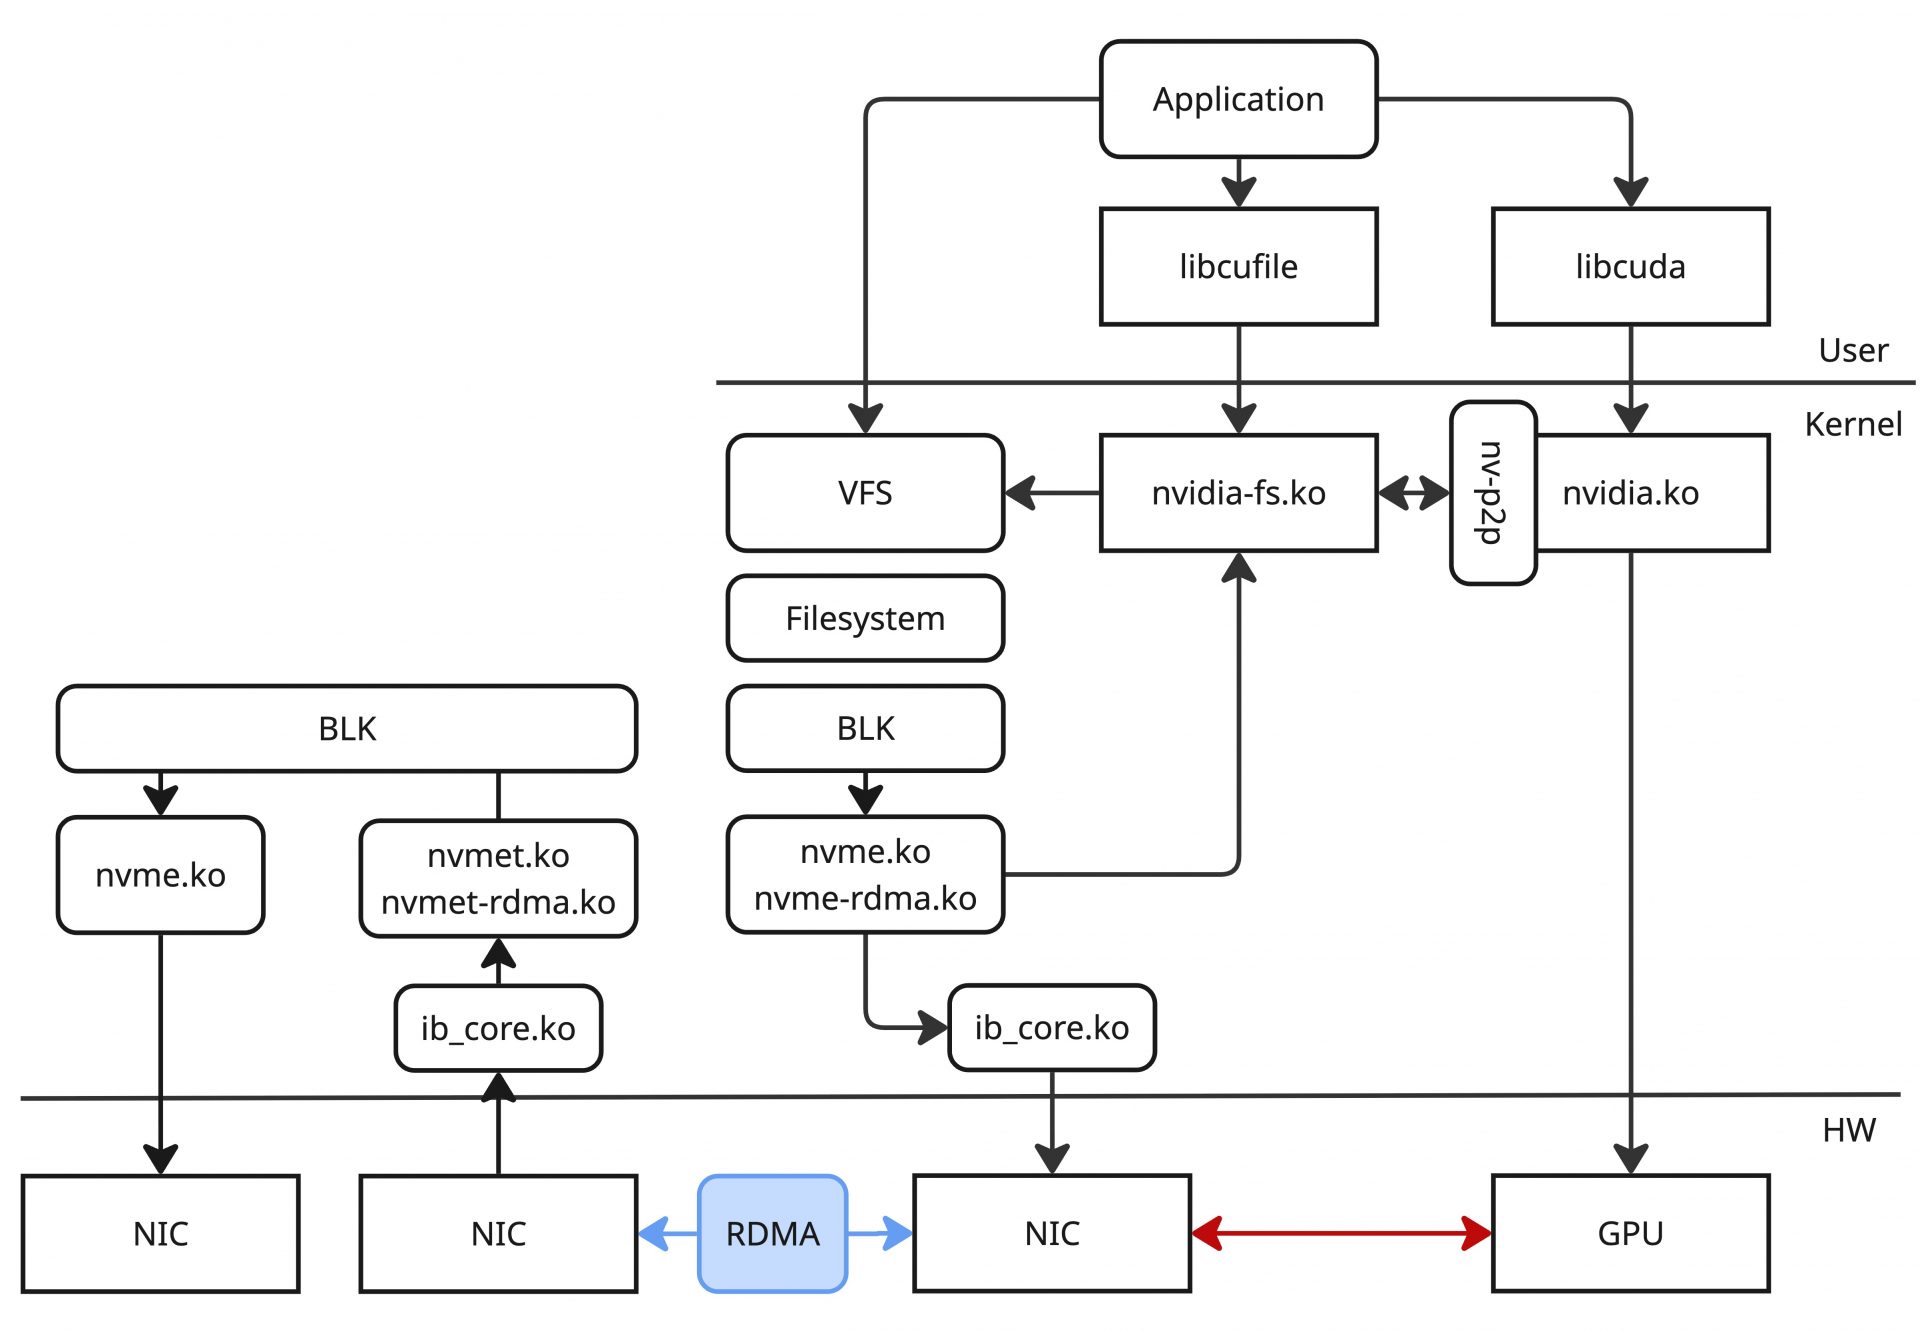
上の図から分かる通り、サーバー側の処理が各種プロトコルスタックを通ることになるため、End-to-Endの処理としては片手落ちのような形になります。本来であれば、NICから直接NVMeに対してDMAできることが望ましいでしょう。
これを実現する技術として、NVMe-oFの場合はNVMe-oF(NVMf)Target Offloadという仕組みがあります。
NVMe-oF Target Offloadは、ターゲット(ストレージサーバー)側のI/OデータパスをNICのハードウェアに肩代わりさせるものです。通常のターゲットでは、受信したNVMeコマンドをカーネルのnvmetがソフトウェアで解釈し、ブロックレイヤー経由でローカルのNVMeにI/Oを発行します。Target Offloadを有効にすると、通常のI/OリクエストはNICが処理し、PCIeのP2P通信でNVMeデバイスに直接コマンドを発行します。
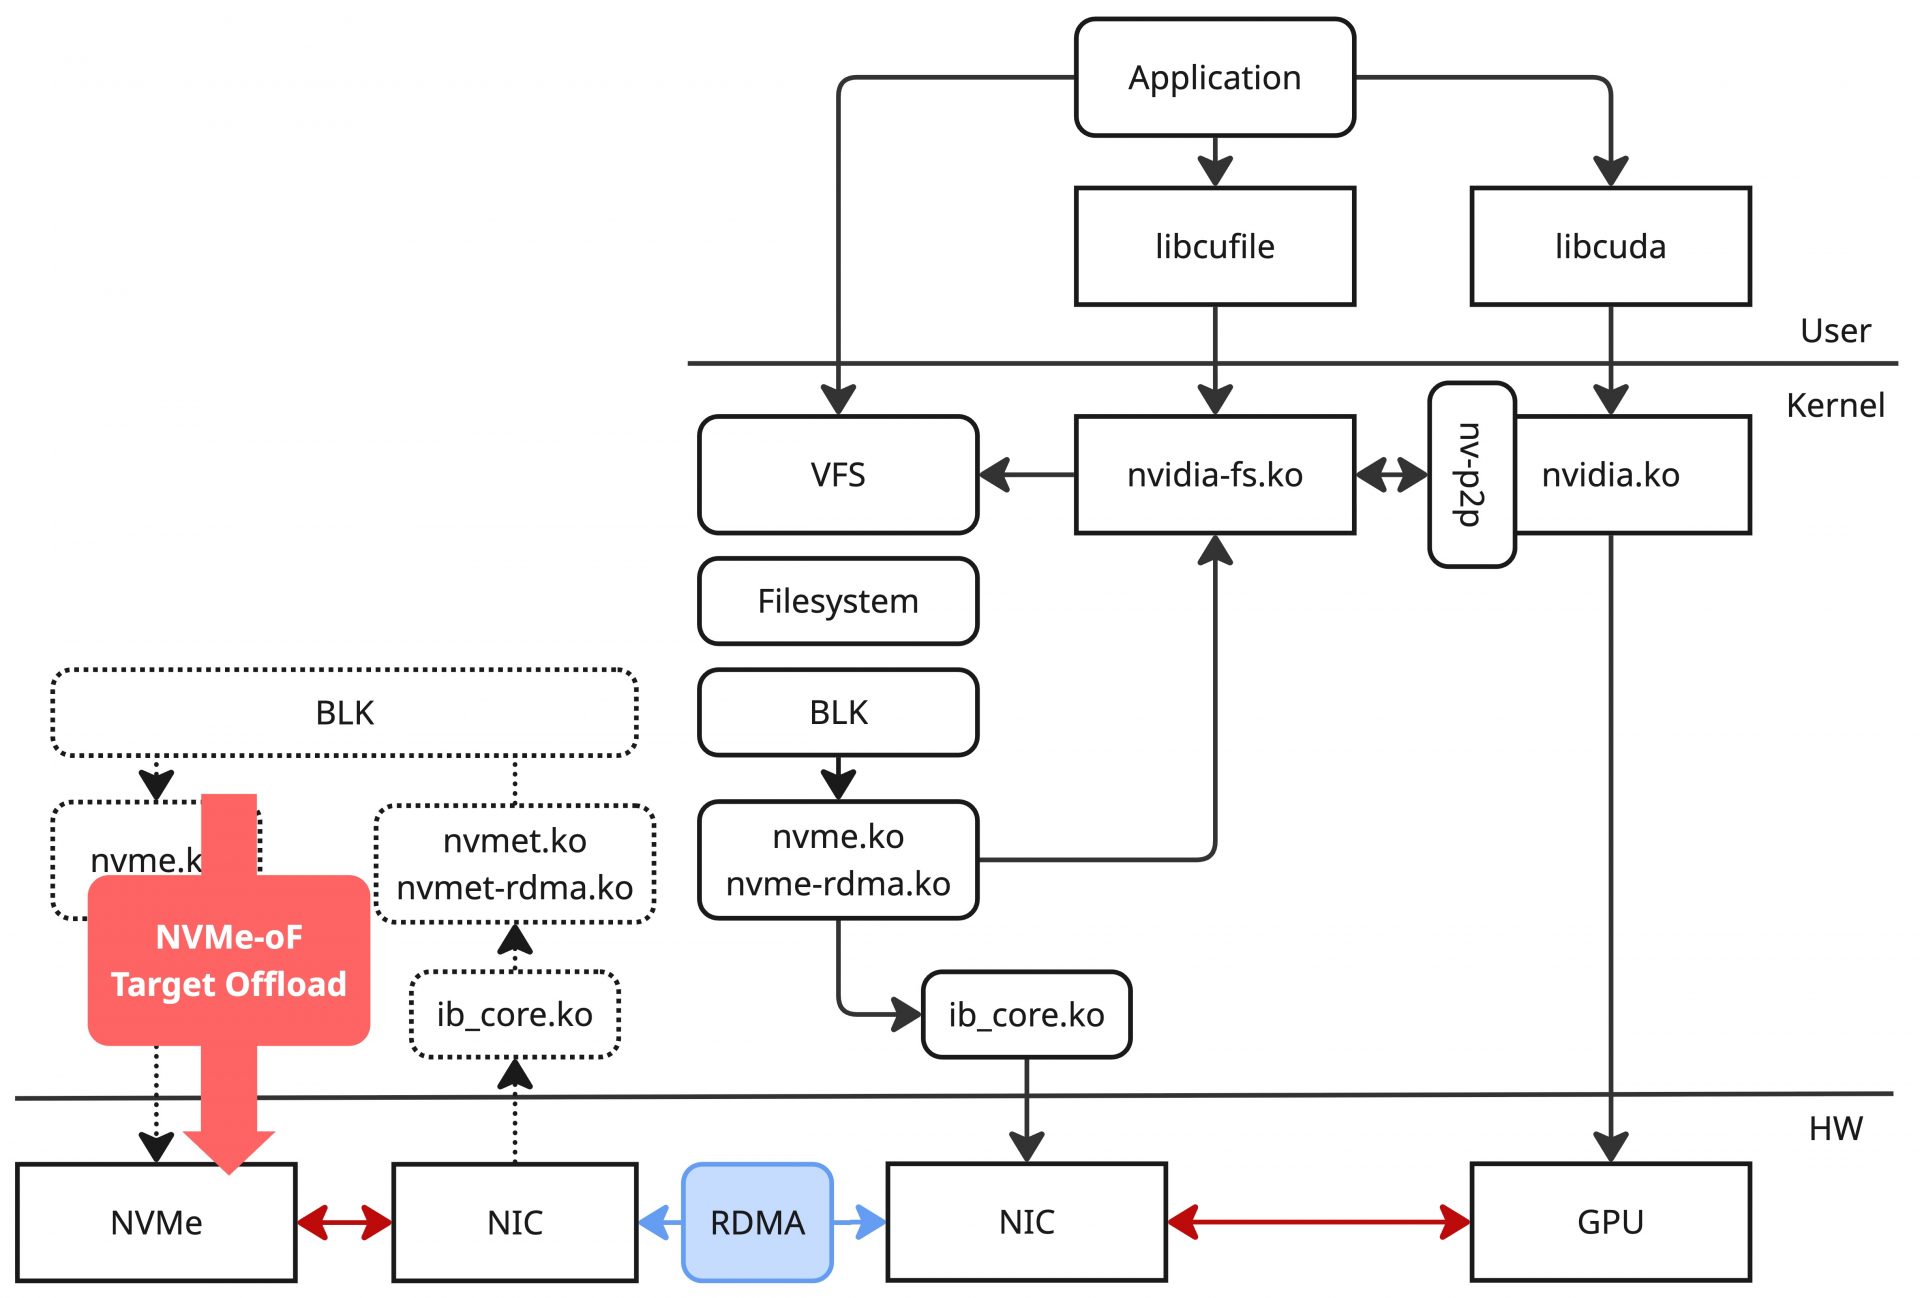
これによってNVMe-oFにおけるEnd-to-Endでのデータの直接転送が実現されます。
上記はあくまでNVMe-oFの例であり、ご存知の通りNFS over RDMAなどリモートストレージアクセスに利用されるプロトコルは他にもいくつか存在します。ただし、それらが全てEnd-to-Endでのデータ転送をサポートしているとは限りません。これはプロトコル面の制約もあればストレージソリューション全体としてどこまで手を加えているかなどによっても違いがあります。DISKに直接I/Oをするのではなく一時受けのメモリー領域に書き込むことでIOを完了とするものもありますし、それはそれで十分に性能は良かったりします。ストレージの領域はそれ自体が奥深く、それぞれの技術によって仕組みも異なるため、深掘りしすぎるのも考えものかもしれません。ただ、詳細を知っておくことで損をすることはないでしょう。
LMCacheとVASTによるKV CacheのOffload
ここまで長らく、KV Cacheの活用に関する概要的な説明と、Storage I/Oという議論で取り上げられることの多いGPUDirect Storageについて詳細に議論してきました。ここからは具体的なソフトウェアとしてLMCacheと、G4レイヤーのネットワークストレージとしてVASTを取り上げ、実際に性能検証を行った話について記載していきます。
LMCache
LMCacheは、KV CacheをGPUメモリー・メインメモリー・外部ストレージ間で階層化・共有し、再計算を削減して推論効率を改善するソフトウェアです。第三回の連載で登場したソフトウェアスタックでもこのソフトウェアを利用していますが、この時はPD Disaggregationの性能測定が主眼であったため、LMCacheはNIXL Backendを用いてKV CacheをPrefillインスタンスからDecodeインスタンスへ転送するための仕組みとして利用していました。今回の議論ではLMCacheのメイン機能の一つである「KV CacheのOffload」に焦点を当てつつ、LMCacheからGDSを利用してEnterprise StorageであるVASTと連携し、その効果測定を行うところまで実施した内容を紹介します。
LMCacheによるKV Cache Offload
LMCacheにはL1、L2と呼んでいるストレージ階層があります。LMCacheにおけるL1はデフォルトではメインメモリーであり、L2はそれ以外のストレージ領域(ローカルストレージ、リモートストレージなど)を指しています。前述したTier図と合わせると、次のような関係性になります。
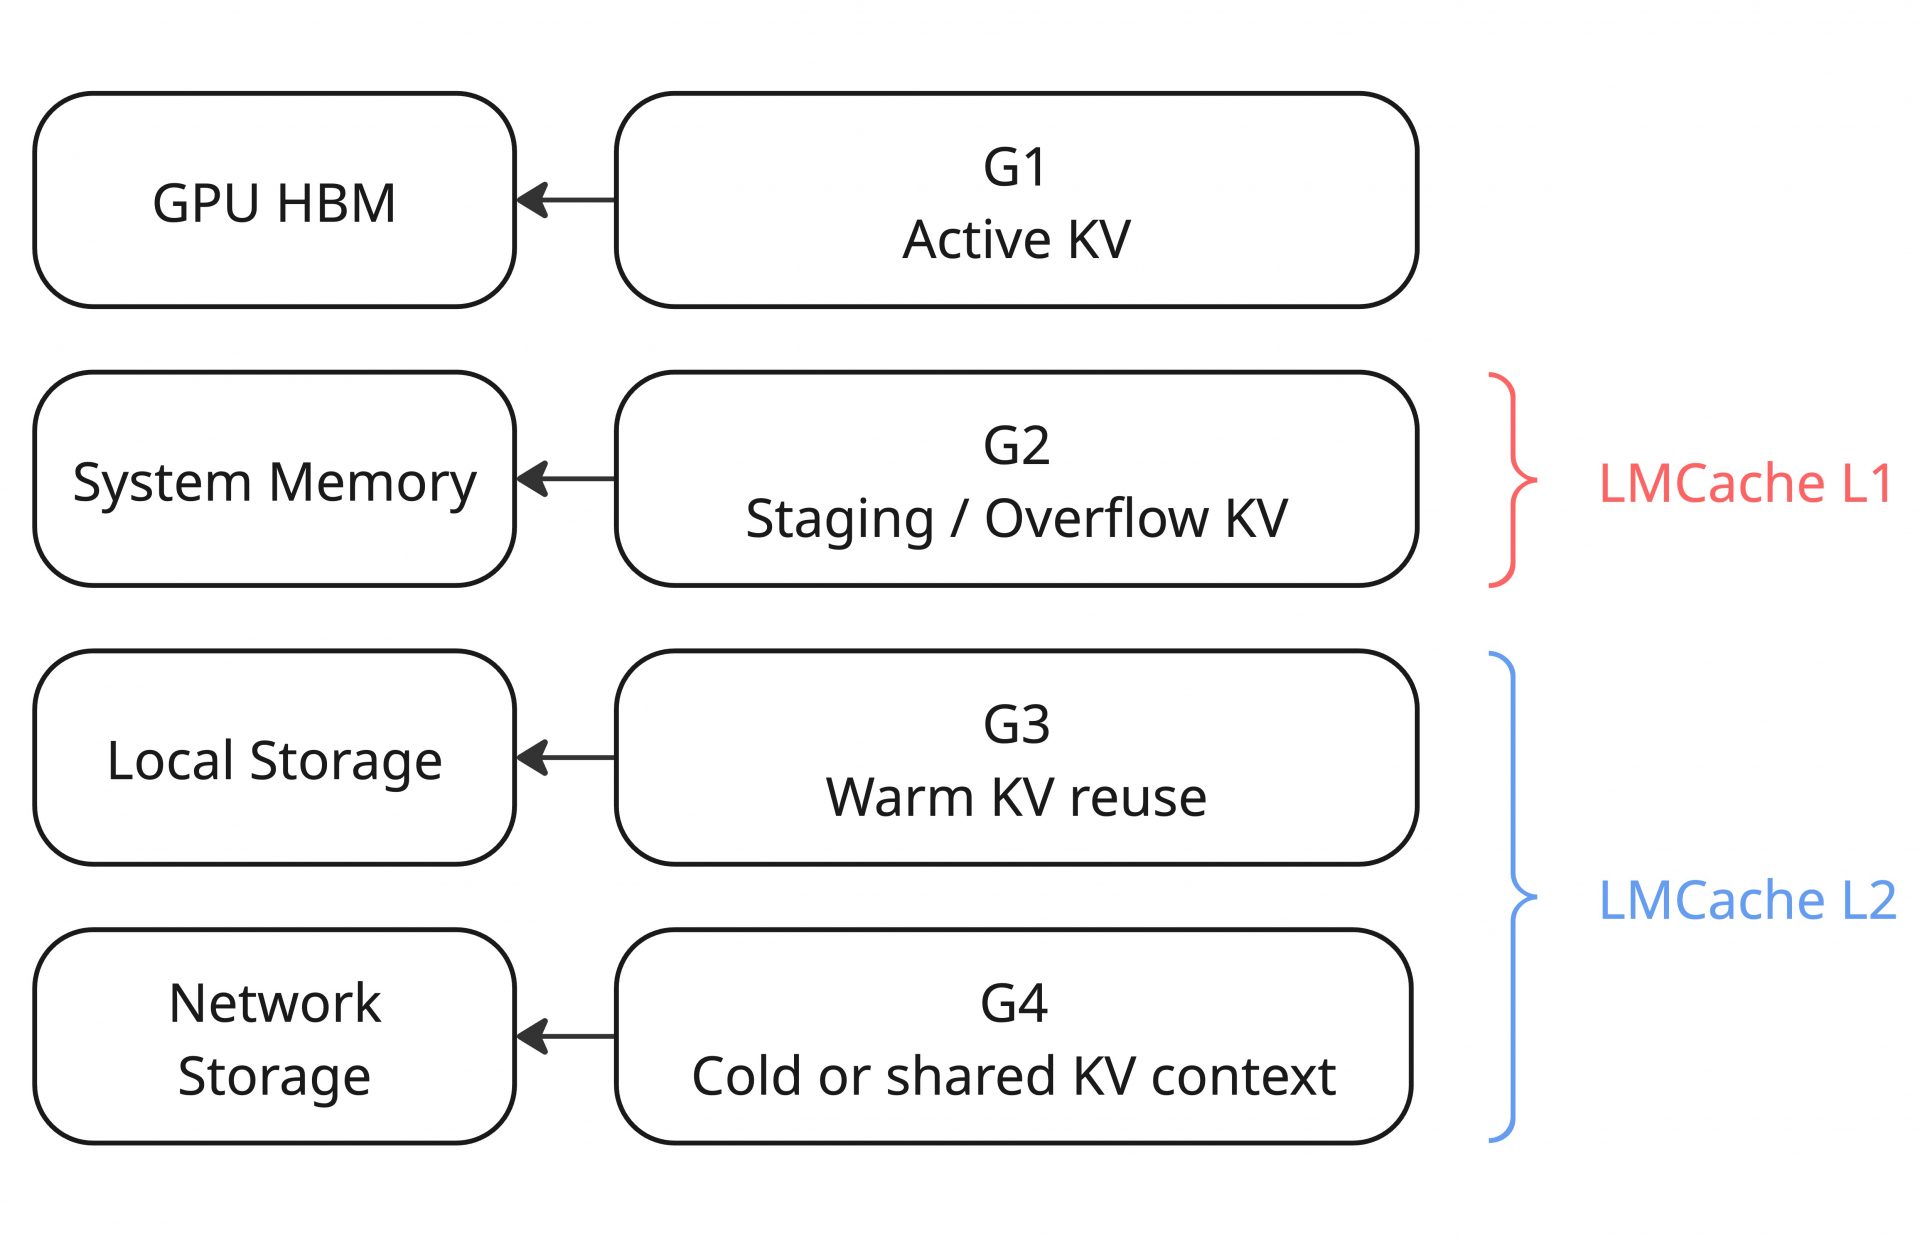
LMCacheはGPUメモリー上のデータをL1やL2にOffloadする機能を提供しており、これまで議論してきたKV CacheのTier上への配置を実質的に賄ってくれるソフトウェア実装の一つです。また、L1とL2のどちらかにしか配置できないというものでもなく、L1にHot Cacheとして配置しているデータを、L2にもCold Cacheとして配置するという透過的な階層保持もサポートしています。
LMCacheのL2にはAdapterという抽象化レイヤーがあり、幅広いL2 Storageのサポートが実現されています。AdapterとしてNIXLを利用する場合はさらにNIXLのBackend(プラグイン)を選択できる構造になっています。今回はL2 AdapterとしてNIXL、BackendとしてGDS_MTを採用し、Enterprise StorageであるVASTとNFS over RDMAで連携する構成を試してみました。
VASTとGPUDirect Storage
VASTは、VAST Data社が提供する、AIや大規模データ処理に向けたスケールアウト型のデータ基盤です。ストレージ機能として、ファイルとオブジェクトを統合的に管理し、NFS・SMB・S3など複数のプロトコルに対応しています。同じデータへ異なるプロトコルからアクセスできるため、用途ごとにデータを複製する手間を抑えながら、既存のファイル共有からAIの学習・推論まで幅広く利用できます。
また、NFS over RDMAを通じたGPUDirect Storage(GDS)にも対応しており、本稿のようにGPUサーバーとの間で高速にデータを転送する用途にも適しています。
CSP(クラウドサービスプロバイダー)の観点としては、マルチテナント機能が充実している点も特徴です。テナントごとにデータ領域やネットワークアクセスを分離し、容量制限、QoSを個別に設定できます。共通のストレージ基盤を複数の顧客で共有しながら、顧客ごとのアクセス管理やリソース制御を行えるため、GPUクラウドのストレージ基盤として近年注目され、採用企業も増えています。
VASTを利用したLMCache L2構成手順
前述した通り、VASTはNFS over RDMAを通じたGDSをサポートしています。そのため、VASTを利用してNFS over RDMAの環境を構築した上で、LMCache L2 Storageとしては、そのNFSに対してGDSを利用してI/Oを実行する環境を整える形になります。
まずはGDSをサポートするNFS over RDMAの構築ですが、これは非常に詳細な公式手順があるため、これをもとに構築することを推奨します。この手順をみるとわかる通り、OFEDをシステムにインストールし、その上でVAST Clientをビルドする流れになっています。ここまで読んできた読者の方々にとって、この手順は納得がいくものだと思います。
VAST Clientが無事インストールできたら、NFSでGDSがサポートされているかをgdscheck -pコマンドで確認してみると良いでしょう。以下のように、「Supported」となっていれば、ひとまずインストール自体はうまくいっています。
$ /usr/local/cuda/gds/tools/gdscheck -p
...
 =====================
 DRIVER CONFIGURATION:
 =====================
 NVMe P2PDMA        : Unsupported
 NVMe               : Supported
...
 NFS                : Supported
...
上記の確認ができたら、NFS over RDMAでマウントできるか確認します。今回は次のようなパラメーターでマウントしています。各種マウントパラメーターに関してはVASTの公式資料などを参照してください。
sudo mount -t nfs \
  -o vers=3,proto=rdma,port=2009,nconnect=16,max_connect=16,rsize=10485760,wsize=10485760,localports=<NIC IP>,remoteports=<VAST VIP Pools>,spread_reads,spread_writes \
  <VAST VIP IP>:<path/to/exports> \
  </path/to/mountpoint>
問題なく上記のマウントができたら、VASTをGDSで利用する準備が整ったことになります。
さて、残るはLMCacheからVASTをL2 Storageとして利用するための設定です。これは非常に単純で、以下のようにLMCache起動時のL2設定を適切に設定するだけで良いです。
--l2-adapter '{
    "type": "nixl_store_dynamic",
    "backend": "GDS_MT",
    "backend_params": {
      "file_path": "</path/to/mountpoint>",
      "use_direct_io": "true",
      "max_capacity_gb": "768",
      "thread_count": "<CHANGE ME>"
    },
    "persist_enabled": true
}'オプションの詳細や設定項目についてはLMCacheのドキュメントを参考にすると良いです。GDS_MTはGDSのMulti-Thread対応版であり、NIXLの公式ガイド(NIXL Storage Transfer Sample: Performance Tips)でもまずはこれを試すよう推奨されているため、それに従っています。今回、スレッド数(thread_count)の値はベンチマーク上で変量としていますが、実際には具体的な数値が入ります。
以上のセットアップによって、LMCacheからNIXLのGDS_MT Backend経由で、NFS over RDMAでマウントしたマウントポイントを利用し、KV CacheをL2 Storage(VAST)に配置する構成が取れたことになります。
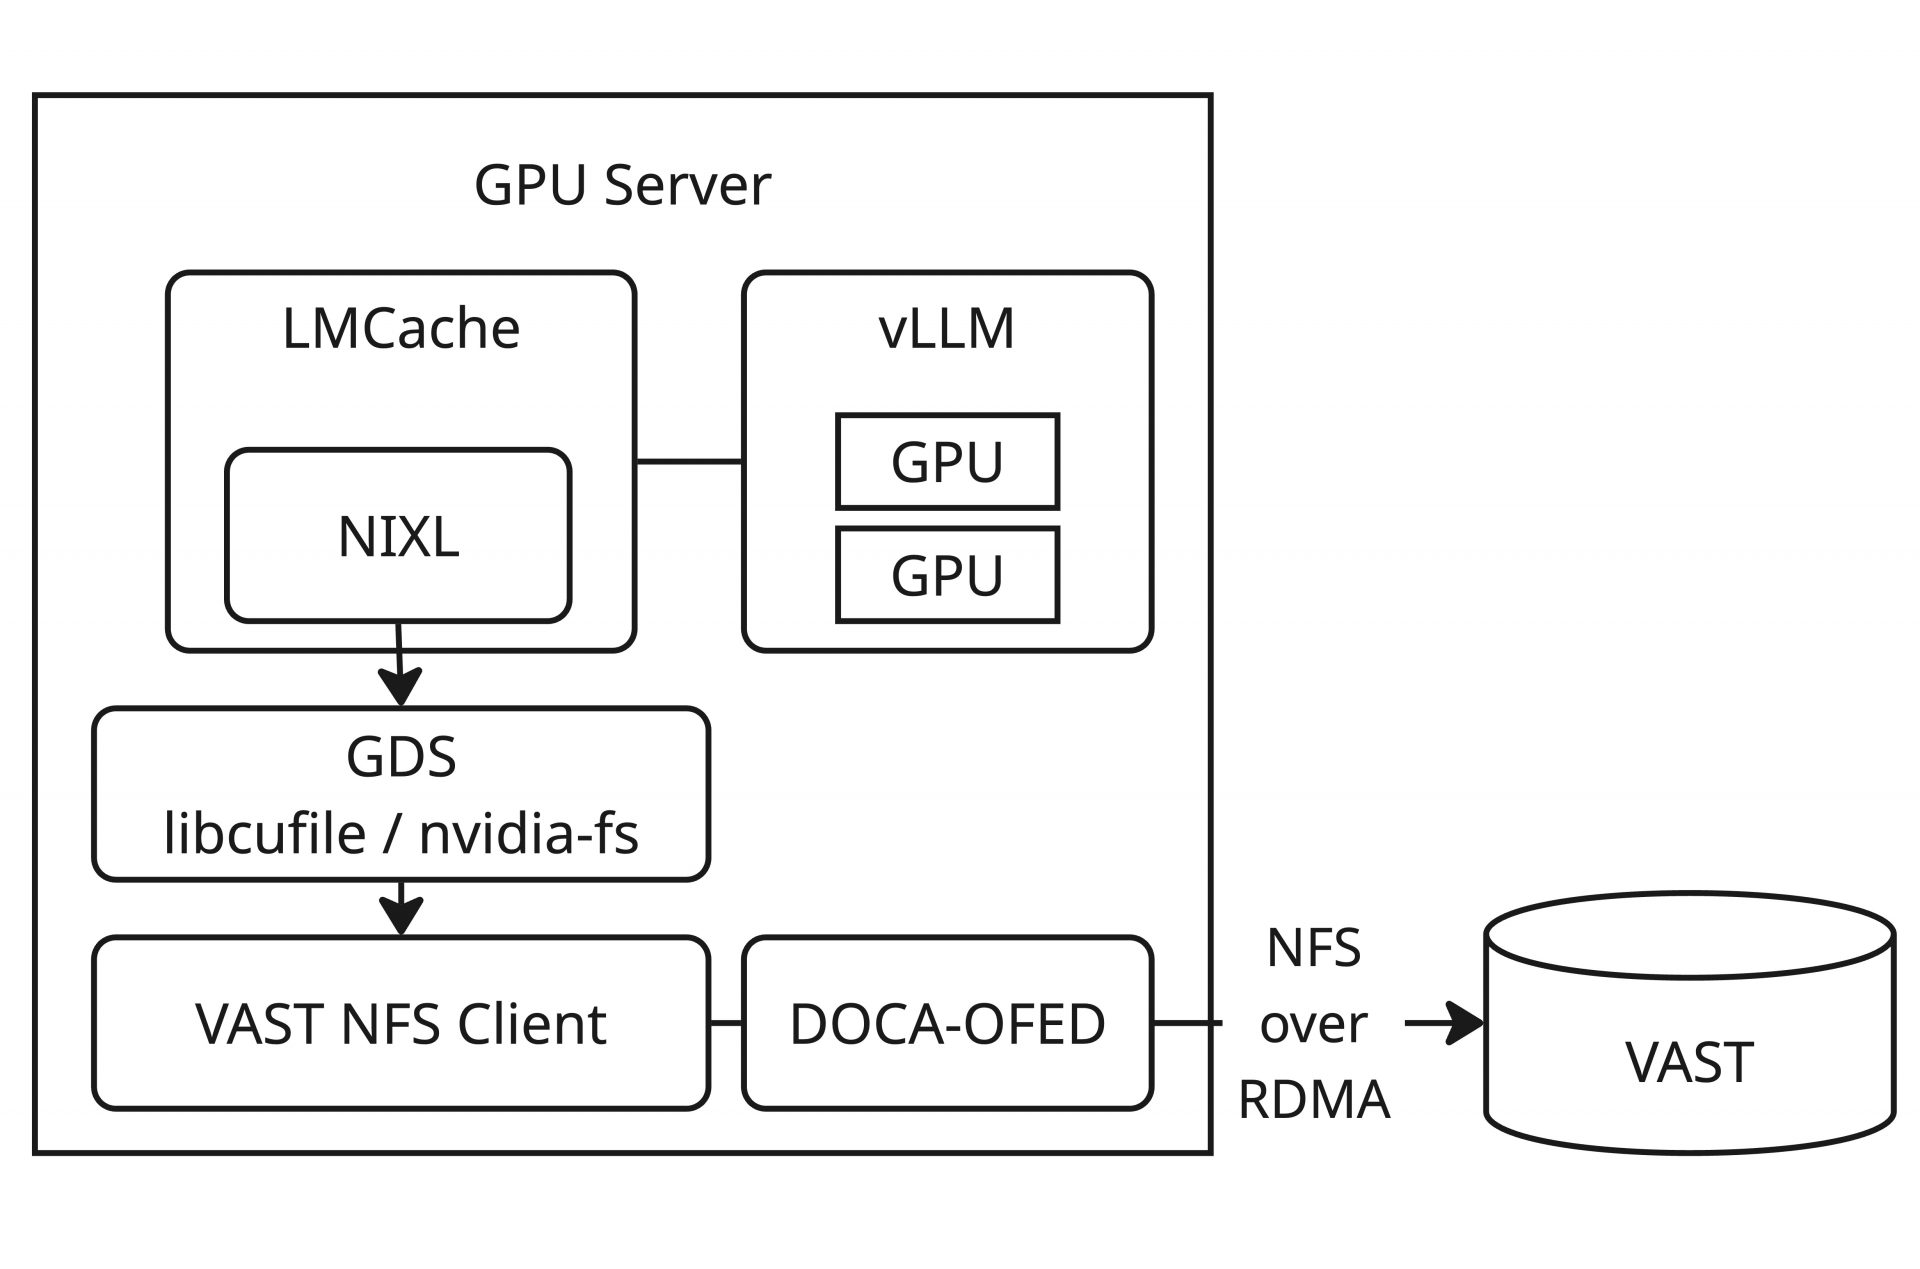
VASTを利用したNFS over RDMAの性能検証、およびGDS(GDS_MTを含む)の検証は別途行っており、KV Cacheの転送性能としては十分な性能が発揮できることが確認できています。本来であればこれらについても詳細に解説したいところではありますが、それ自体でかなりのボリュームになってしまう上に本稿の趣旨からやや外れるため割愛とさせていただきます。
基本的な構成方法について整理できたところで、ここからは性能検証の話に移ろうと思います。実際の検証環境はここまでの話を前提としてKubernetesの環境に構築しているため、もう少しだけ説明が必要になります。ただ、ここまで説明してきた内容をもとに読んでいただけば、そこまで難しいことはないでしょう。
KV CacheのL2 Storage効果検証
検証環境の詳細
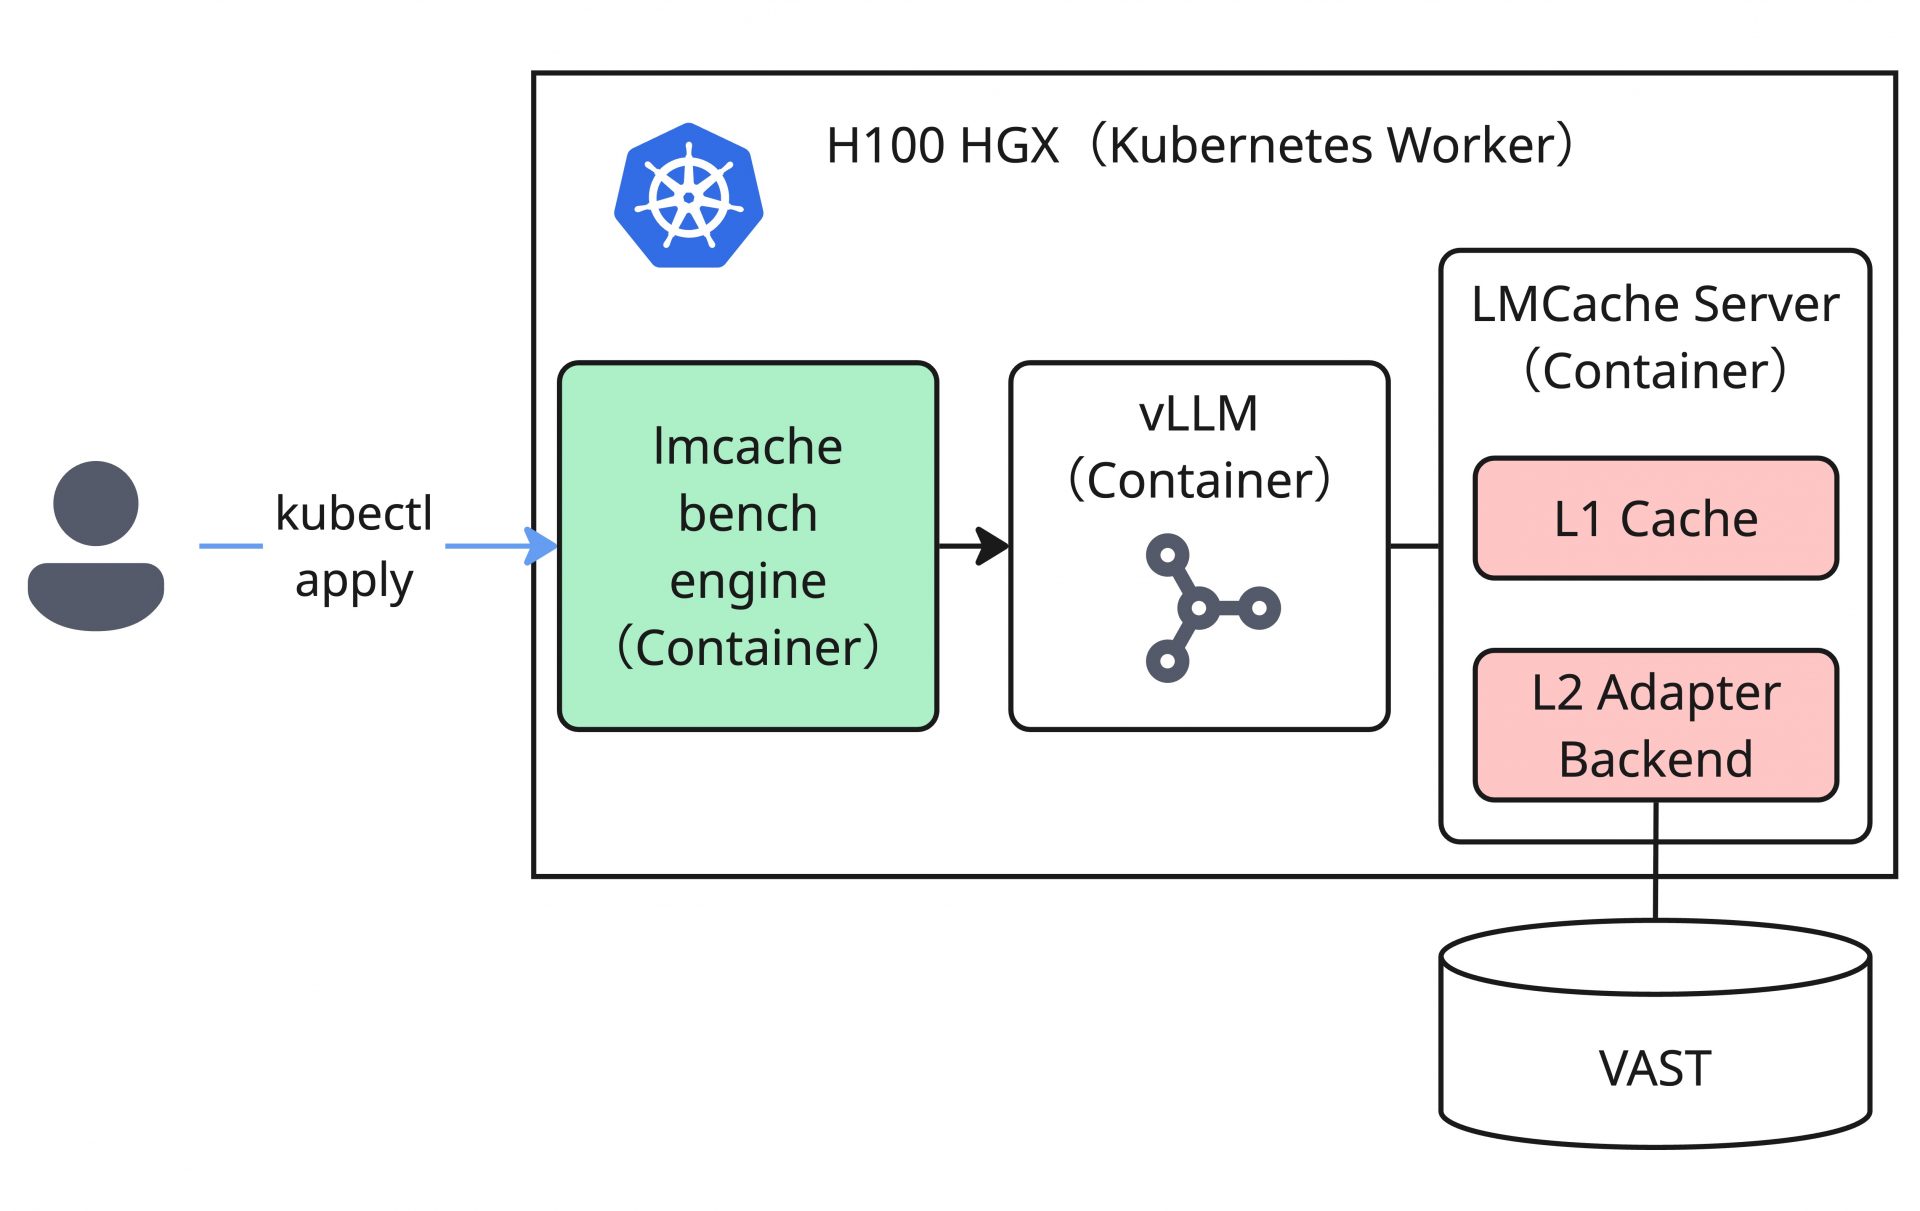
今回の検証ではプロダクションユースを意識し、検証に利用するGPUサーバーをKubernetesのWorkerノードとしてセットアップし、このWorkerノード上にvLLMインスタンス、LMCache、ベンチマークプログラムをスケジュールするようにします。また、OFEDやGPU Driverなどのサーバーのセットアップは、NVIDIAから提供されている各種Kubernetes Operator(NVIDIA Network Operator、およびNVIDIA GPU Operator)によってセットアップされています。
ただし、この構成の採用には現状は注意点があるため明記しておきます。本稿執筆時点で、公式に提供されるVASTクライアントのセットアップは、NVIDIA Network OperatorによってOFEDをセットアップした今回のような環境では、そのままではうまくいきません。これは、通常のパッケージマネージャによるOFEDのインストールパスとOperatorによるOFEDのインストールパスが異なることや、その他依存ツールの解決に失敗するためです。結果として、ビルドスクリプトはInboxドライバーを利用してVAST Clientをビルドしてしまい、NFS over RDMAでマウントする際に、シンボル解決が失敗するようになります。この問題についてはVAST社にフィードバック済みですが、今回の検証環境ではVASTが提供するビルドスクリプトを修正し環境を調整することで、上記の環境で問題なく動作するようにしました。もし、Operatorを利用せず、OFEDのインストールをパッケージマネージャなどで行っている場合はこの問題を踏むことはないでしょう。
話を戻して、サーバーの構成について説明します。今回のサーバーもこれまでと同様、さくらの高火力PHYで提供しているHGX H100サーバーを1台利用しています。これはH100 GPUを8枚搭載し、ストレージ用に2本のNICを備えています。インターコネクト用のNICも搭載していますが今回はシングルノードでの検証となるため省略します。
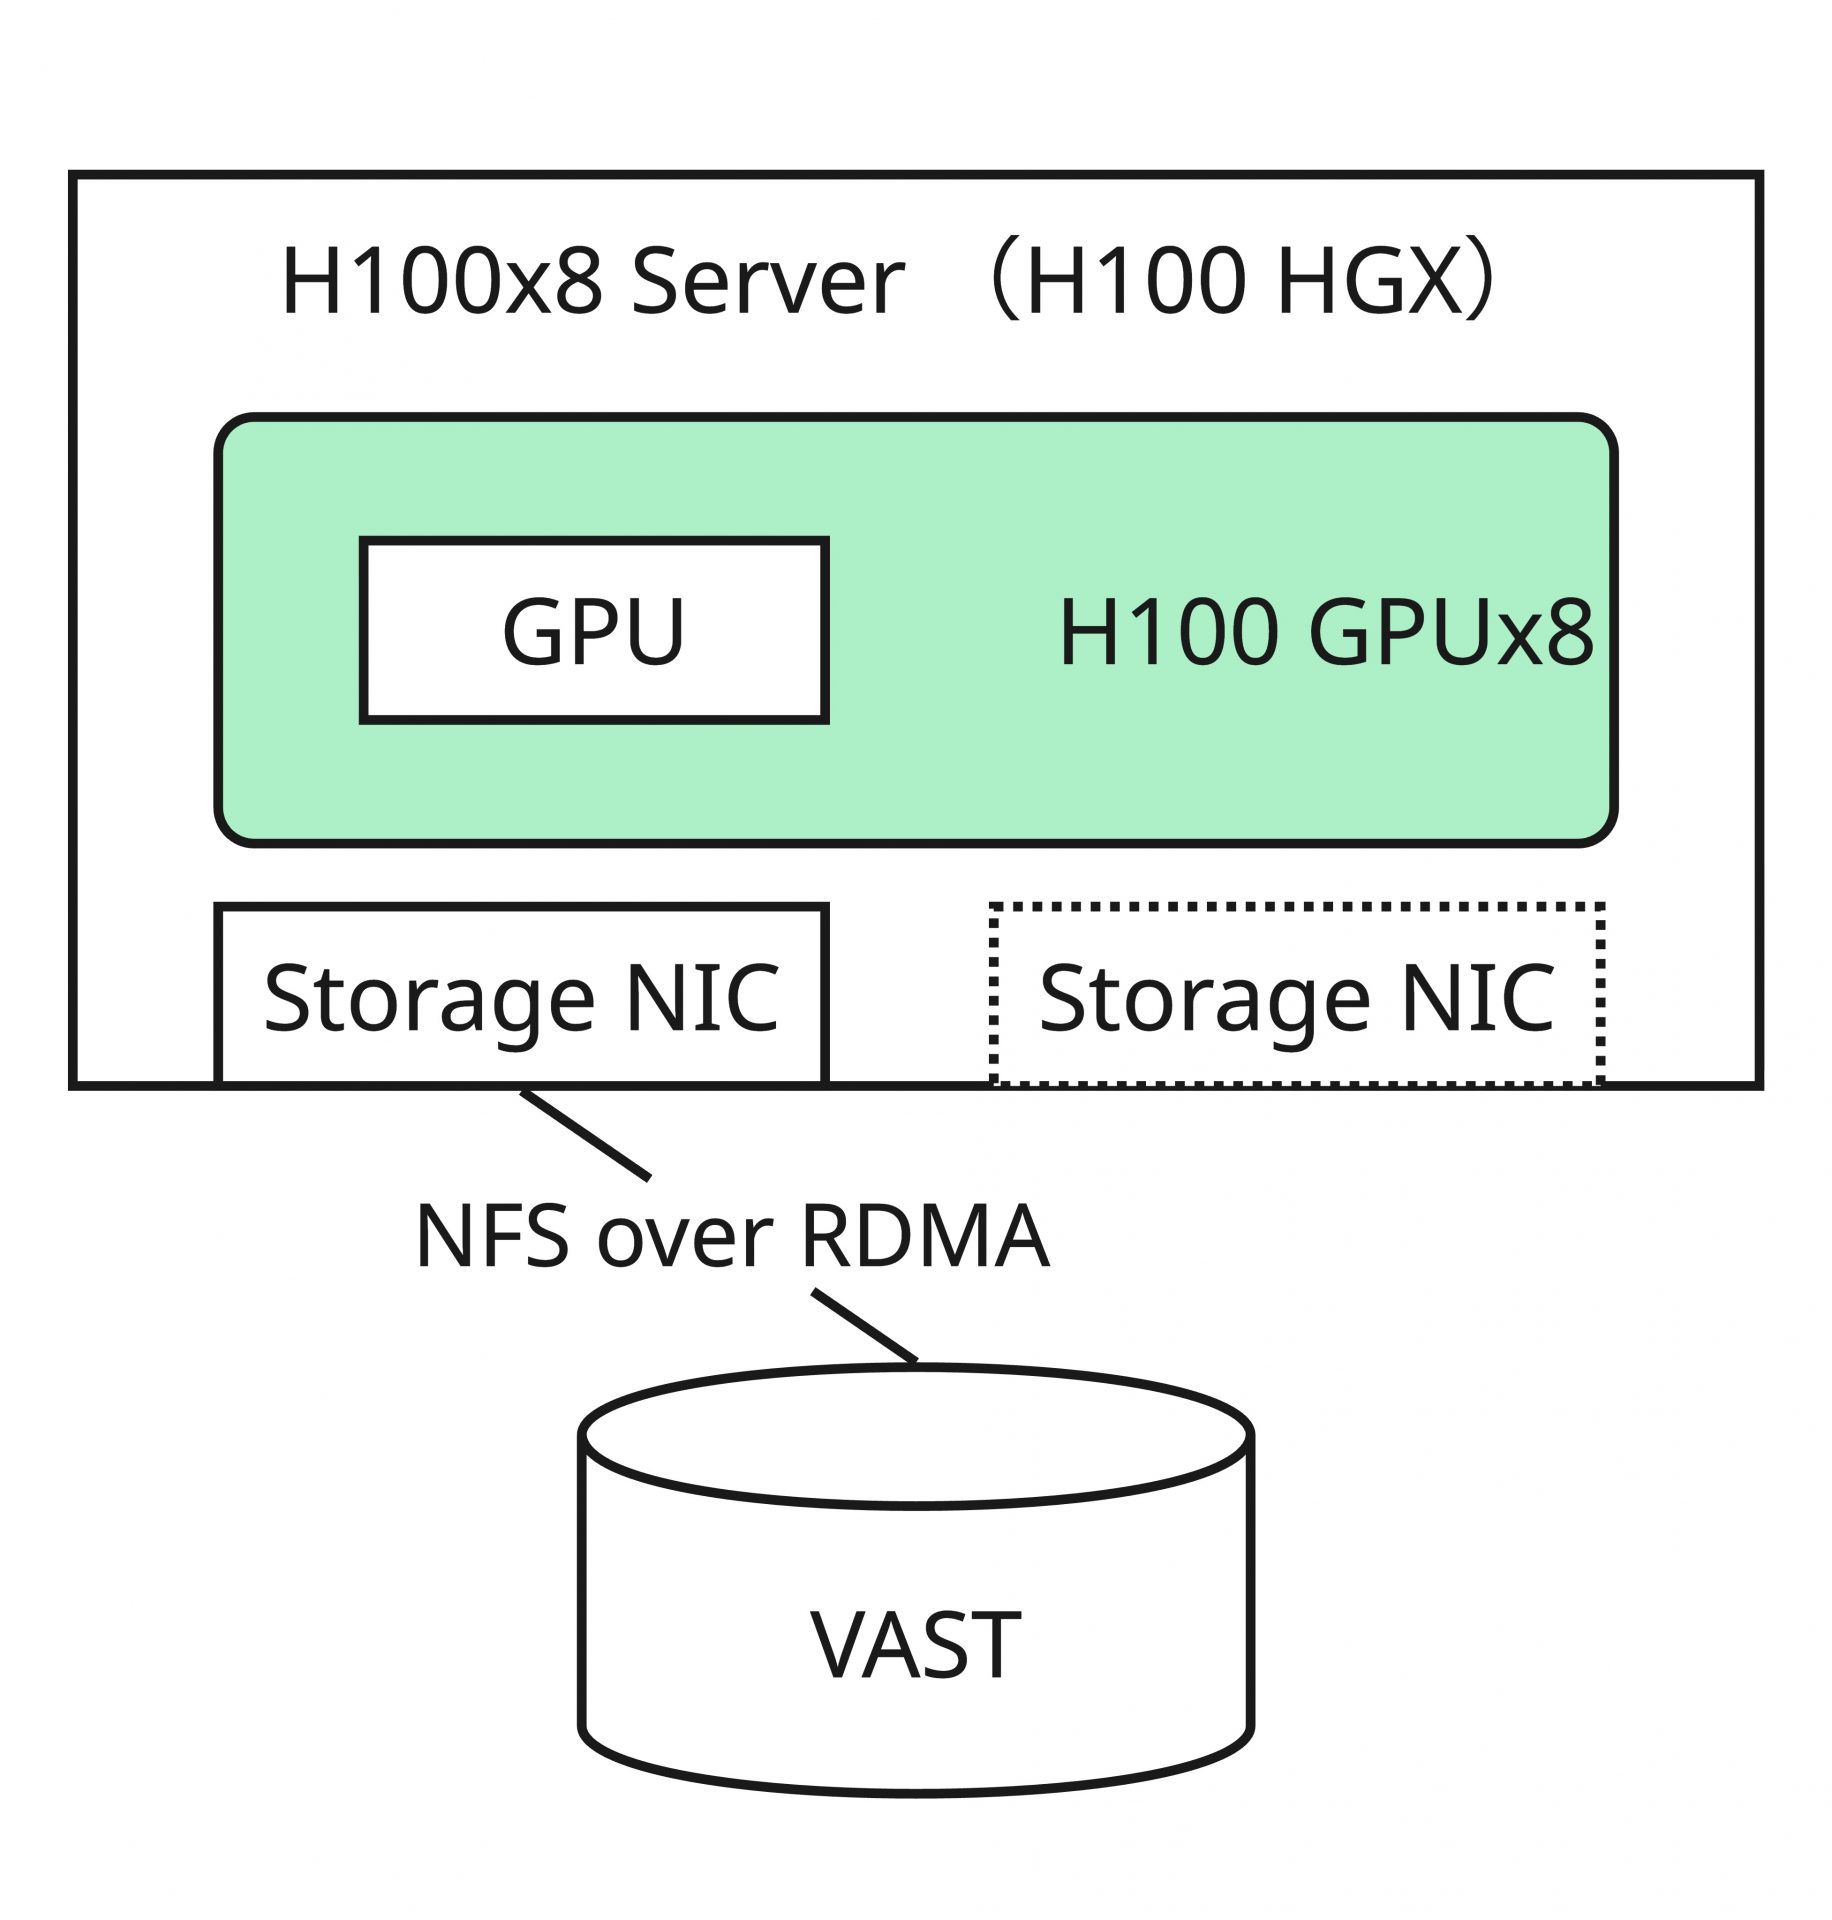
今回の検証では、検証環境の設計の都合上、2本のストレージ用NICのうち1本だけを利用します。本来VASTでは、サーバーの複数NICを束ねて利用する機能も存在しているため、VAST自体の性能検証という観点から見るとやや片手落ちな構成ですが、推論基盤におけるL2 Storageの効果測定という目的であれば大きな問題はないでしょう。
さて、KubernetesのWorkerであるこのHGX H100サーバー上に、推論インスタンスとLMCacheのデプロイを行う必要があり、さらにLMCacheからはVASTに接続できる必要があります。今回はVASTが公式で提供しているCSI DriverをHelmでデプロイし、LMCacheのPodからマウントできるようにします。デプロイ時に利用したvalues.yamlから関連するStorageClassの設定、そしてNFS over RDMAのマウントに関する部分を抜粋すると以下のようになります。
...
storageClasses:
  vastdata-filesystem:
    secretName: "<secret for vast>"
    secretNamespace: "<secret namespace>"
    vipPool: "<VAST VIP Pool Name>"
    storagePath: "</path/to/mountpoint>"
    viewPolicy: "<VAST policy>"
    mountOptions:
      - vers=3
      - proto=rdma
      - port=20049
      - nconnect=16
      - localports=<NIC IP>
      - remoteports=<VAST VIP Pools>
      - rsize=10485760
      - wsize=10485760
      - spread_reads
      - spread_writes
...
また、推論インスタンスとLMCache Serverはそれぞれ別Podとして当該サーバーにデプロイしています。後述の説明のために、LMCache ServerとvLLMのManifestを一部のみ抜粋します。
---
apiVersion: apps/v1
kind: Deployment
metadata:
  name: vllm-qwen3-235b-dpep
spec:
  ...
  template:
    spec:
      ...
      resourceClaims:
      - name: shared-gpus
        resourceClaimName: h100x8-share.nvidia.com
      containers:
      - name: vllm
        image: lmcache/vllm-openai:v0.5.4rc5
        imagePullPolicy: IfNotPresent
        command: ["vllm", "serve"]
        args:
        - Qwen/Qwen3-235B-A22B-Instruct-2507-FP8
        - --port
        - "8000"
        - --enable-expert-parallel
        - --data-parallel-size
        - "8"
        - --gpu-memory-utilization
        - "0.8"
        - --max-num-batched-tokens
        - "1024"
        - --max-model-len
        - auto
        - --kv-transfer-config
        - '{"kv_connector":"LMCacheMPConnector","kv_role":"kv_both","kv_connector_extra_config":{"lmcache.mp.port":6555, "lmcache.mp.mq_timeout":300}}'
        ...
        resources:
          claims:
          - name: shared-gpus
---
apiVersion: apps/v1
kind: Deployment
metadata:
  name: lmcache-server
spec:
  ...
  template:
    spec:
      ...
      volumes:
        - name: vast
          persistentVolumeClaim:
            claimName: vast-kvcache-rdma
      resourceClaims:
        - name: shared-gpus
          resourceClaimName: h100x8-share.nvidia.com
      containers:
        - name: lmcache-server
          image: lmcache/vllm-openai:v0.5.4rc5
          command:
            - lmcache
            - server
            - --host
            - "0.0.0.0"
            - --port
            - "6555"
            - --http-port
            - "8080"
            - --chunk-size
            - "256"
            # L1
            - --l1-size-gb
            - "512"
            - --l1-align-bytes
            - "1048576"
            - --eviction-policy
            - LRU
            - --max-gpu-workers
            - "8"
            - --max-cpu-workers
            - "8"
            # L2
            - --l2-store-policy
            - default
            - --l2-prefetch-policy
            - retain
            - --l2-prefetch-max-in-flight
            - "8"
            - --l2-adapter
            - '{ "type" : "nixl_store_dynamic", "backend": "GDS_MT", "backend_params": {"file_path": "/vast/rdma", "use_direct_io": "true", "max_capacity_gb": "768", "thread_count": "1"}, "persist_enabled": true}'
          volumeMounts:
            - name: vast
              mountPath: /vast/rdma
          resources:
            claims:
- name: shared-gpus今回は再現性の獲得や複雑性の排除を考慮し、公式に公開されているコンテナイメージをベースにデプロイしています。また、上記のManifestからわかる通り、モデルはQwen3-235B-A22B-Instruct-2507-FP8 を採用しました。このモデルはMixture-of-Experts(MoE)モデルであり、Expert Parallel + Data Parallelによって、単一WorkerのH100 GPUを8枚利用してデプロイする構成をとっています。さらに、LMCacheはIn-Process Modeではなく、推奨構成であるMultiprocess(MP)Mode、およびL1、L2の両方を利用する階層的なキャッシュ構造を採用しています。イメージとしては下図のようになります。
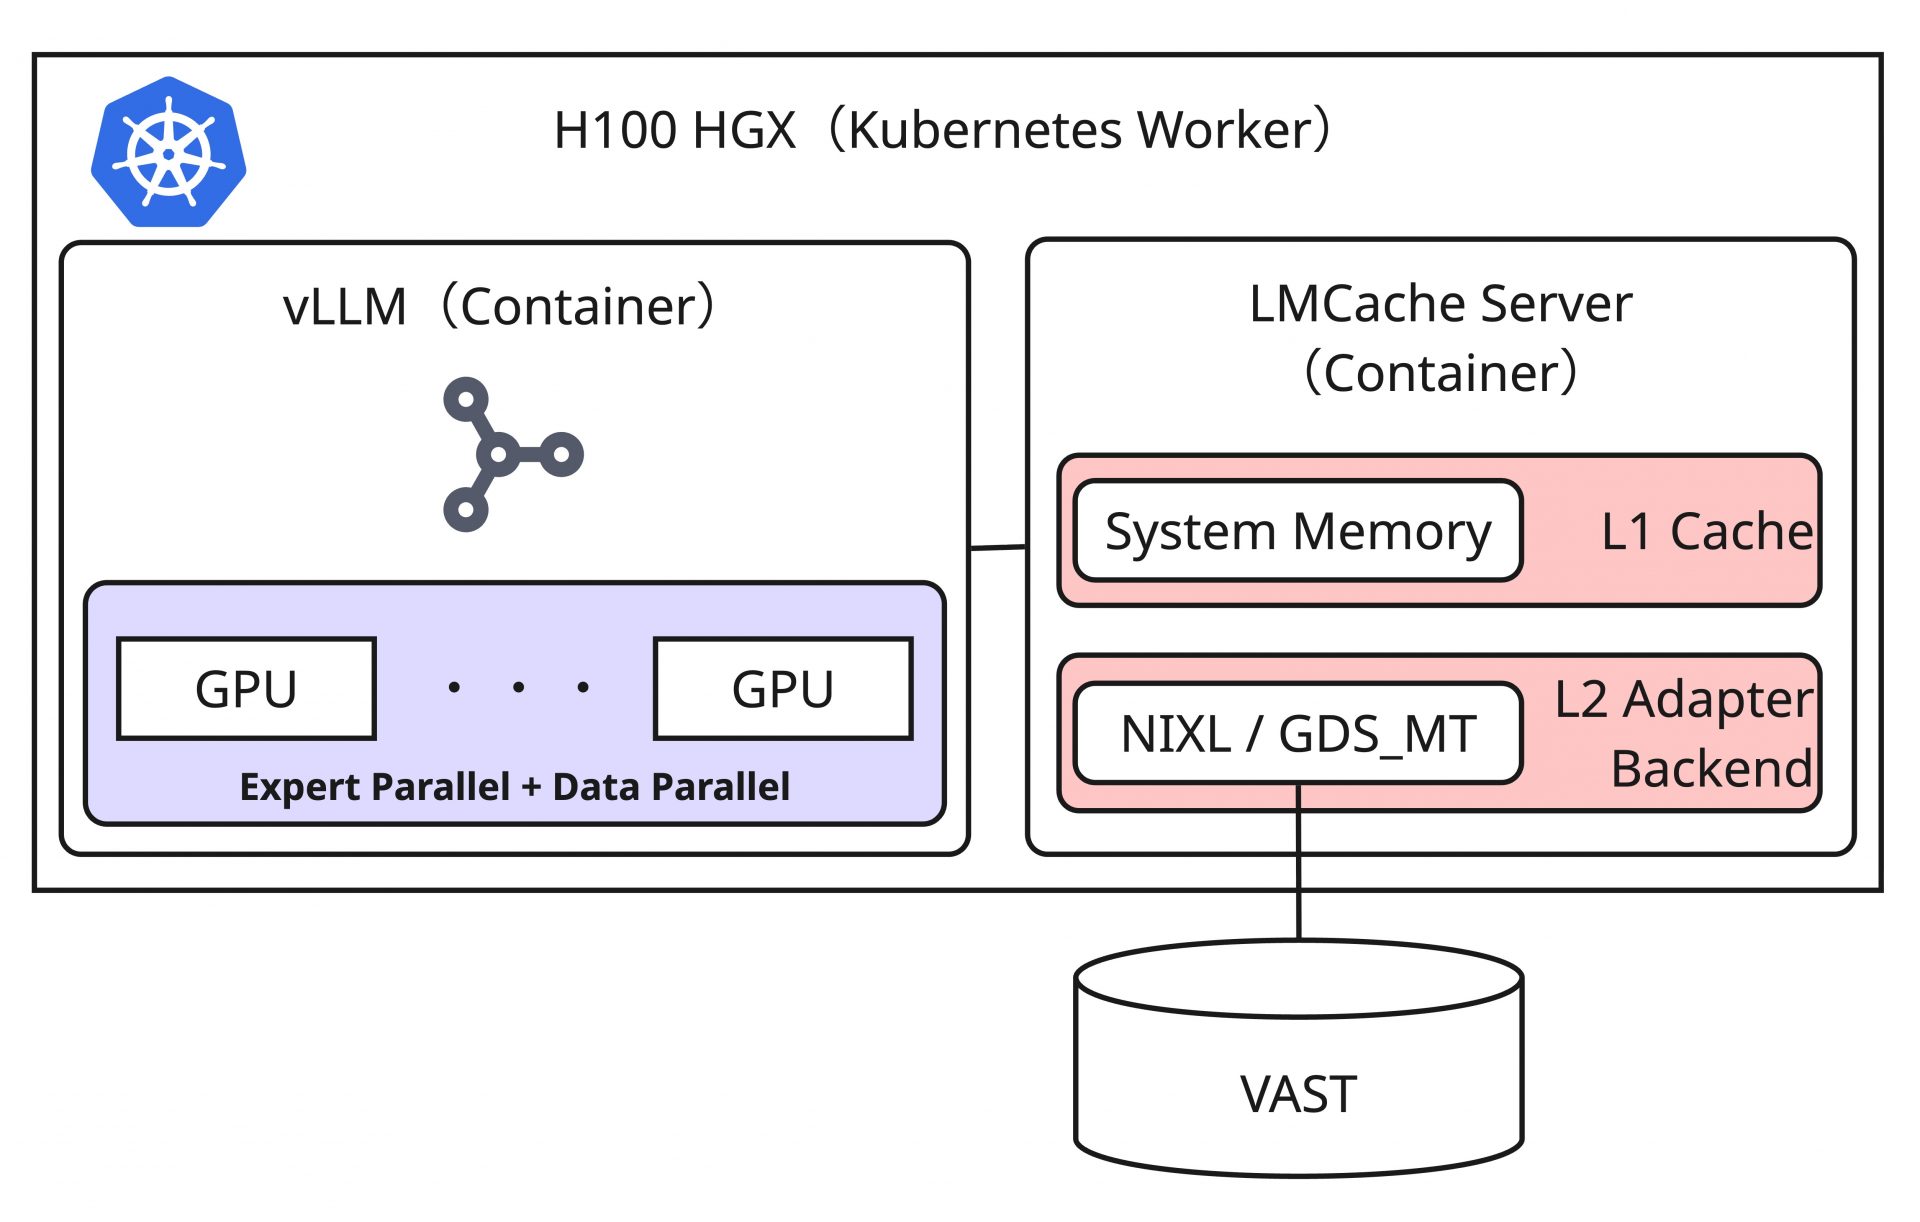
今回のデプロイにおけるParallelismの選択や、省略した部分のManifestの内容などについては、主題から外れるため本記事では詳細に説明しませんが、次回の連載記事で少し触れようかと考えています。
さて、vLLMとLMCacheの設定をみるとわかる通り、今回の検証では以下のような設定にしています。
- vLLMからは、LMCacheMPConnectorを利用しLMCacheと連携
- LMCacheのL1 Cacheサイズ(KV Cache用にメインメモリーをどの程度割り当てるか)を512GiBに制限
- LMCacheのL2 Adapterには
nixl_store_dynamicを採用し、backendにはGDS_MTを指定。NFS over RDMAでマウントしたファイルパス(volumeMountsで指定)を利用して、Direct I/Oを有効にして書き込む
L1 Cacheサイズ(メインメモリー)を本来サーバーが備えているメモリー容量(1.5TiB)より小さい値で固定しているのは、今回の測定がL2の性能測定を主眼としているためです。実際のプロダクション環境ではサーバーのメインメモリーをより多く割り当てることで、今回試験するワークロードより強い負荷までL1容量内に抑えられるでしょう。
検証ワークロード設計
今回のワークロードの設計ですが、シンプルなMulti-Round Chatを採用しました。このワークロードの模擬には、LMCacheが提供する lmcache bench engine コマンドを採用しています。
このコマンドはワークロードの指定とともに、その指定したワークロードに関する細かいパラメーターの設計を行うことができ、特に今回のように特定のKV Cacheサイズを狙ってベンチマークを実行したい場合などに便利です。今回は、以下のような設定を採用しています。
{
  "model": "Qwen/Qwen3-235B-A22B-Instruct-2507-FP8",
  "workload": "multi-round-chat",
  "ignore_eos": false,
  "kv_cache_volume": 640,
  "tokens_per_gb_kvcache": 5577,
  "mrc_shared_prompt_length": 2000,
  "mrc_chat_history_length": 30000,
  "mrc_user_input_length": 128,
  "mrc_output_length": 256,
  "mrc_qps": 0.5,
  "mrc_duration": 600.0
}
このパラメーターをもとにベンチマークの概要を図示すると、次のような形になります。
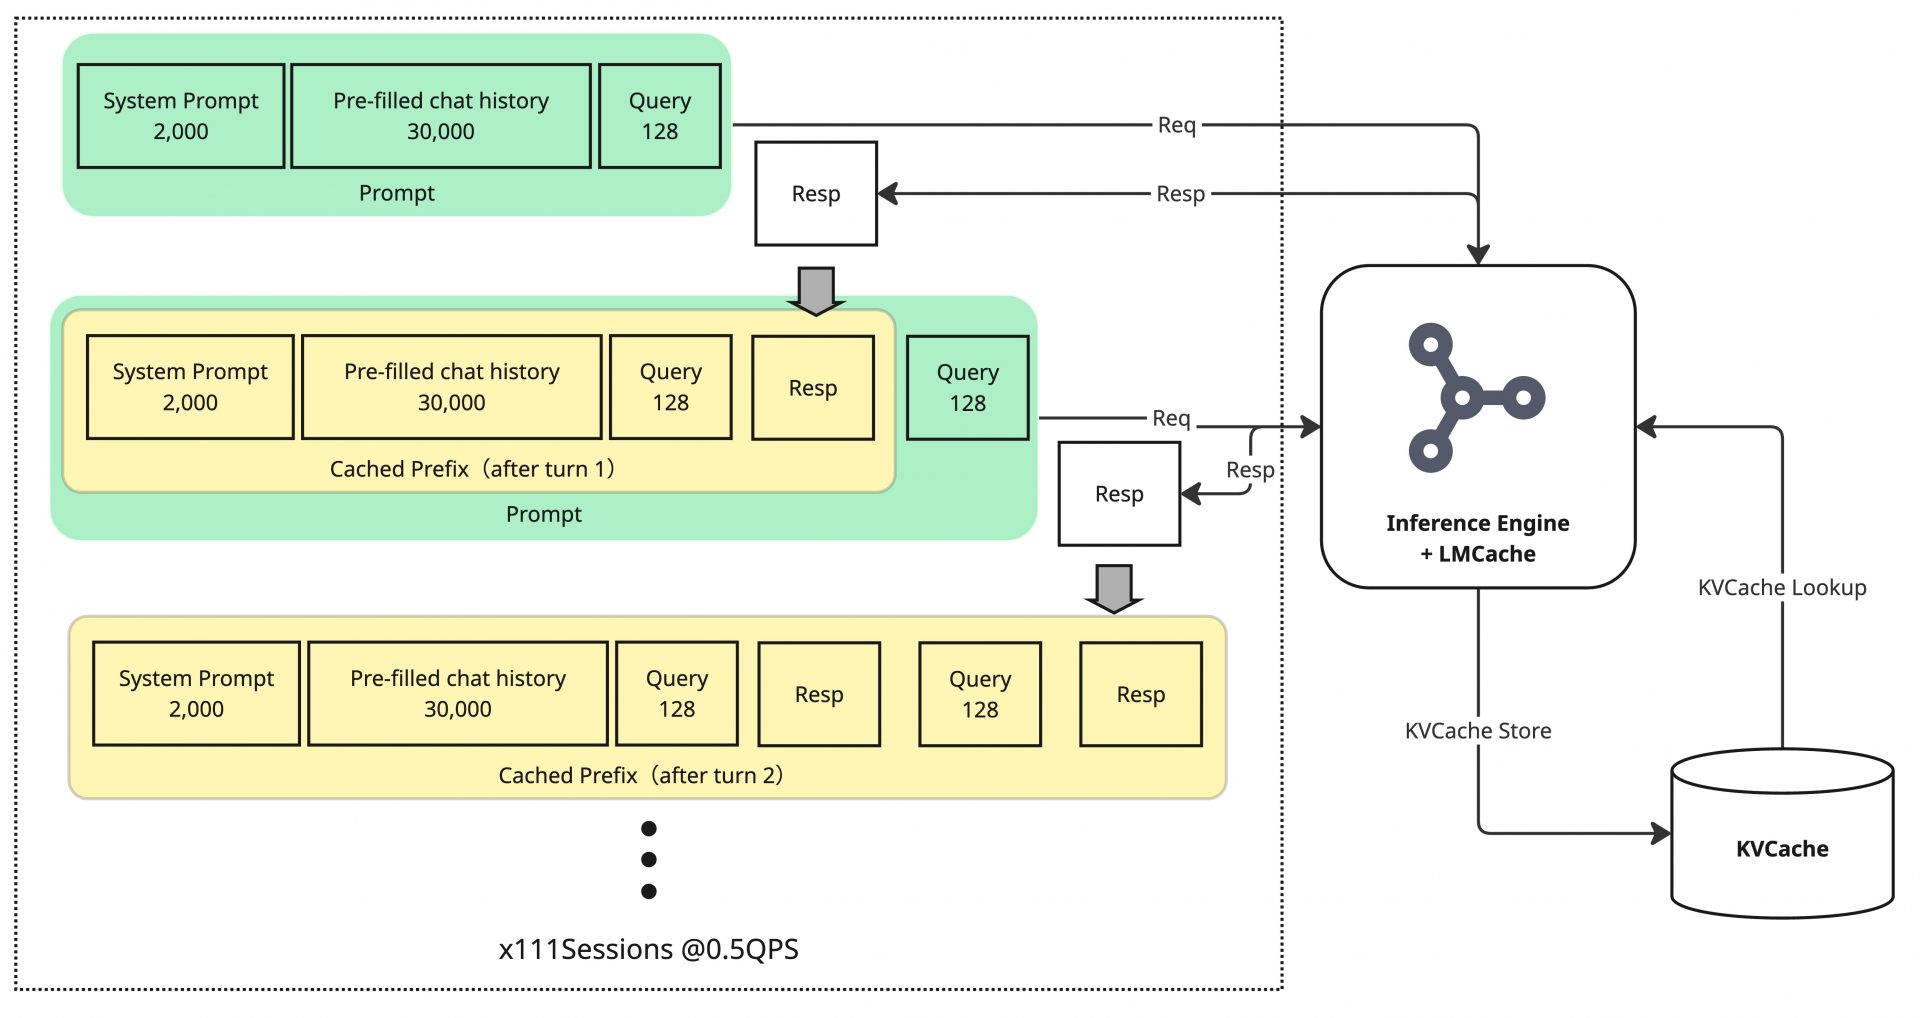
今回の設計では、Turn 1の入力Tokenは、System Prompt(mrc_shared_prompt_length)+ Chat History(mrc_chat_history_length)+ User Input(mrc_user_input_length)の合計になるため、32,128 Tokensです。これに対して、1GiBあたりのKV CacheのToken数(tokens_per_gb_kvcache)は5,577(tokens/GiB)のため、この入力に対するKV Cacheのサイズは32,128 / 5,577 = 5.76(GiB)になります。このtokens_per_gb_kvcacheは、lmcache bench engineがLMCache Serverから自動で取得する値を一度ダンプし、それをそのまま設定値として利用しています。
そして、今回指定しているKV Cacheのサイズは640 GiBであるため、このワークロードは640 GiBを満たす数のセッションを生成します。セッション数の算出にはSystem PromptとChat HistoryのToken数(32,000)が用いられ、User Inputや生成されるTokenはこの計算には含まれないため、 640 × 5,577 / 32,000 ≒ 111 セッションとなります。
つまり、1セッションあたり約32,000 Token、全体で約111セッションというワーキングセットを作成する形になります。
このワークロード設計は今回の測定対象であるL2 Storageの効果が確認できるように恣意的に設計しています。検証の目的には合致していますが、一般的なワークロードではないことには留意が必要です。
実際の測定において、上記のベンチマーク設定はConfigMapとして作成し、それを利用するKubernetes Jobを当該サーバーにデプロイすることで測定しています。
検証結果
検証結果を以下に示します。大別するとL1のみのケース(橙色)と、L1 + L2の組み合わせ(青色)のケースの2パターンがあり、後者はさらにスレッド数を変化させた場合の性能値をそれぞれプロットしています。それぞれの測定では、4パターン(P50、mean、P90、P99)の値を色の濃淡で表現しています。縦軸はTTFTを指し、これは小さい値ほど良い性能であるということを意味します。
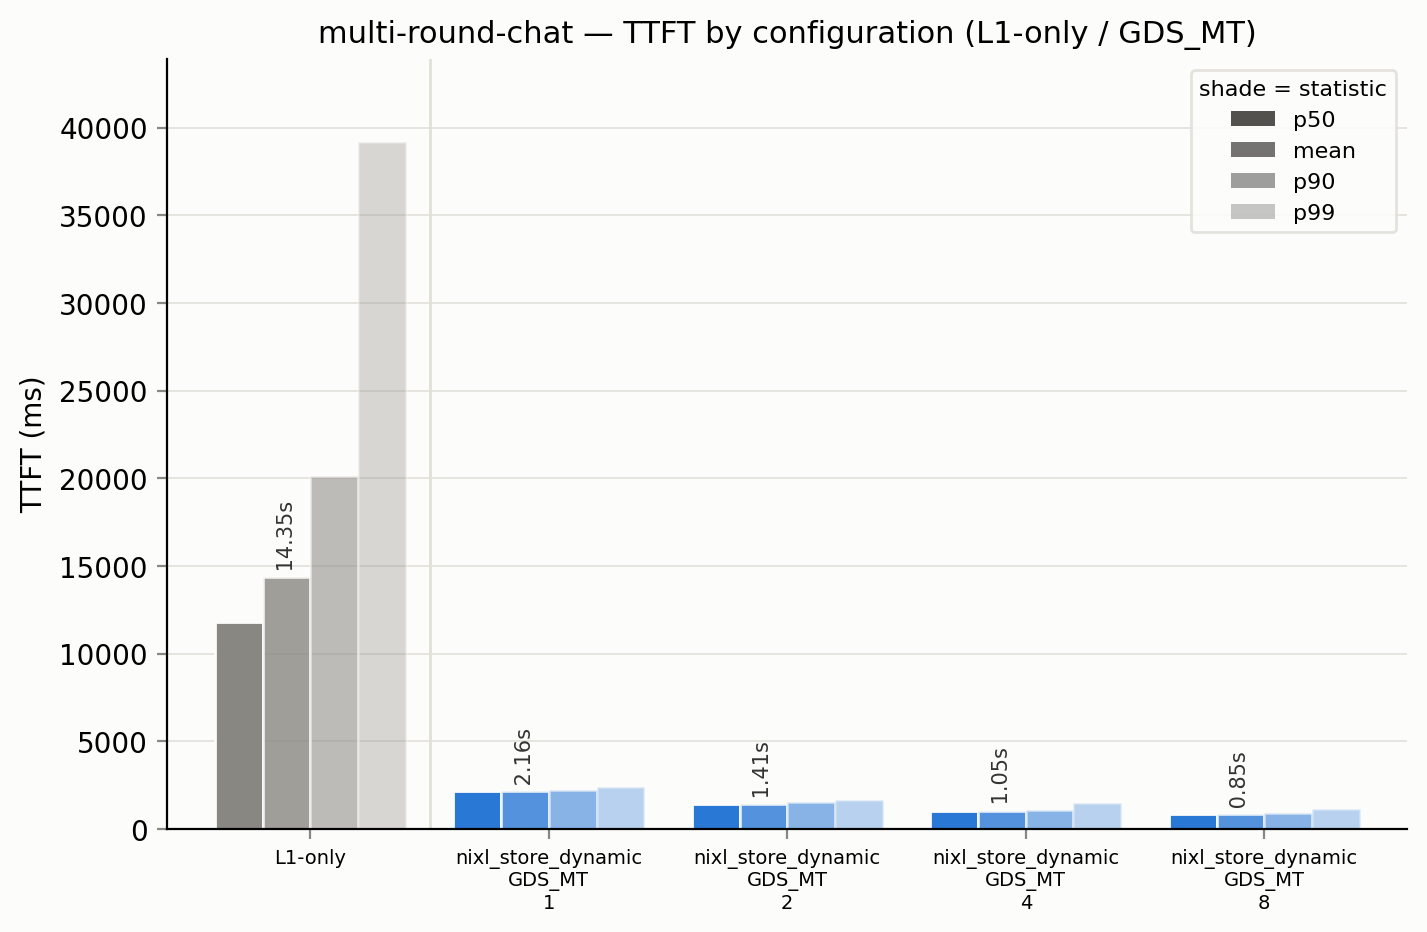
見て分かる通り、L1のみを利用するケースと比較して、L1 + L2のケースはTTFTの値がかなり良く、かつP99に至るまで比較的安定した性能を推移しています。これは前述した通り、KV CacheがL1 Cacheに収まらない一方で、L1 + L2では収まり、かつKV Cacheの再利用が基本的には効くようなベンチマーク設計であるため、当然の帰結と言えるでしょう。当然、全ての環境、任意のワークロードでこのような改善を得られるわけではありませんが、L1 Cacheを超えるような負荷の推論環境において、L2 Storageによる性能改善は期待できそうです。
また、スレッド数の変化による性能の向上幅については、今回の測定においては2スレッド以上になるとあまり変化が見受けられませんでした。これは、今回のワークロード環境では、スレッド数を増やしても解消されない別の要因によって律速されているのだろうと想定されます。今回これ以上の深掘りはしていませんが、ワークロードを変化させたり、パラメーターを変化させることで、スレッド数の違いによる性能影響がより色濃く見えてくる可能性はあるかもしれません。
追試:KV Cacheの階層的Offloadにおけるデータ転送とGDS
先ほどの測定データと同様のパラメーター設定を利用し、L2 AdapterにNIXL(GDS_MT)ではなく、POSIXベースのデータ転送であるfs_native(Direct I/Oを有効)、およびNIXL(POSIX)を採用したケースの性能を測定して同様にプロットしたところ次のようになりました。fs_nativeは、LMCacheがC++で実装したファイルシステム向けのL2 Adapterであり、複数のワーカースレッドが、チャンクデータ1つを1ファイルとして通常のPOSIX read/writeで読み書きする実装になっています。
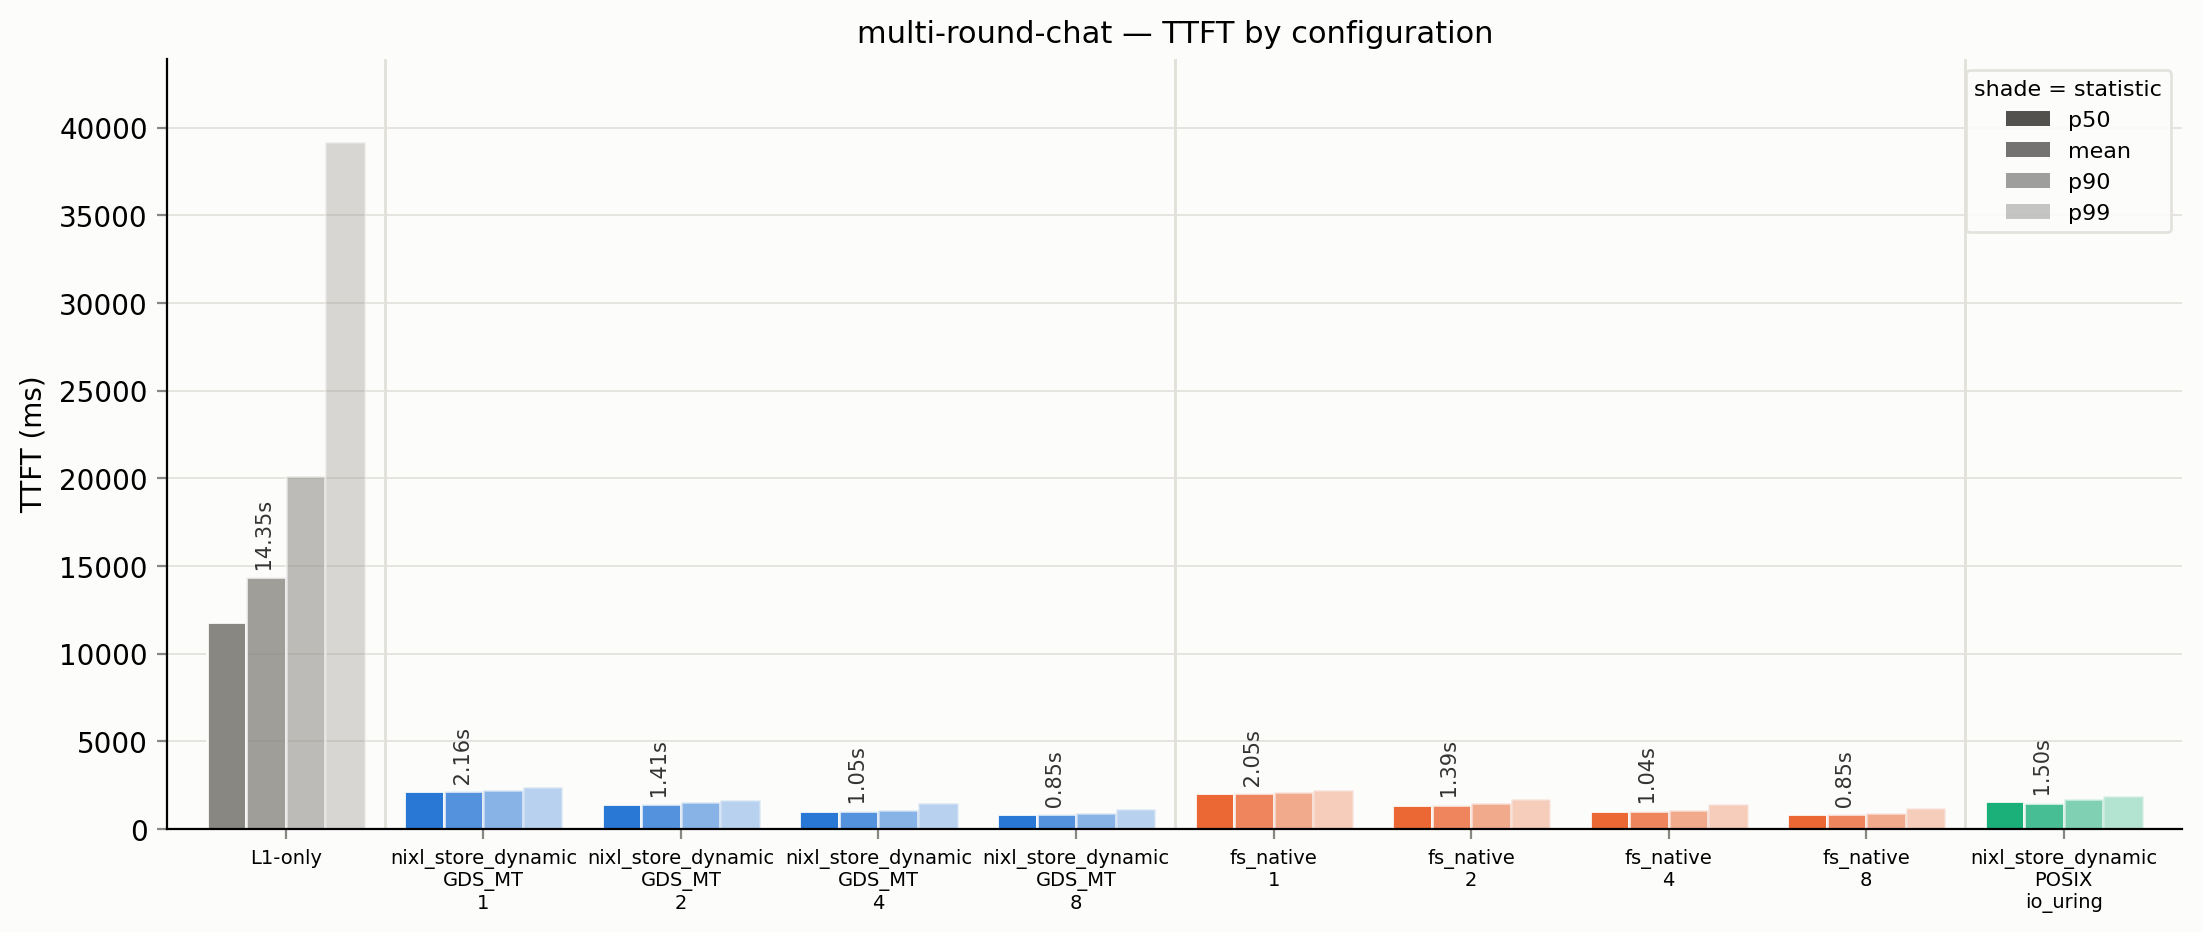
これをみると、NIXL(GDS_MT)に対して、fs_nativeもNIXL(POSIX)も遜色のない性能傾向を示すことがわかります。さらに詳細に比較するために、各リクエストをもとにBox Plotを作成したものが以下の図になります。これをみても、基本的にNIXL(GDS_MT)とfs_nativeは性能の分布も概ね類似しており、同様のパフォーマンスに見えています。
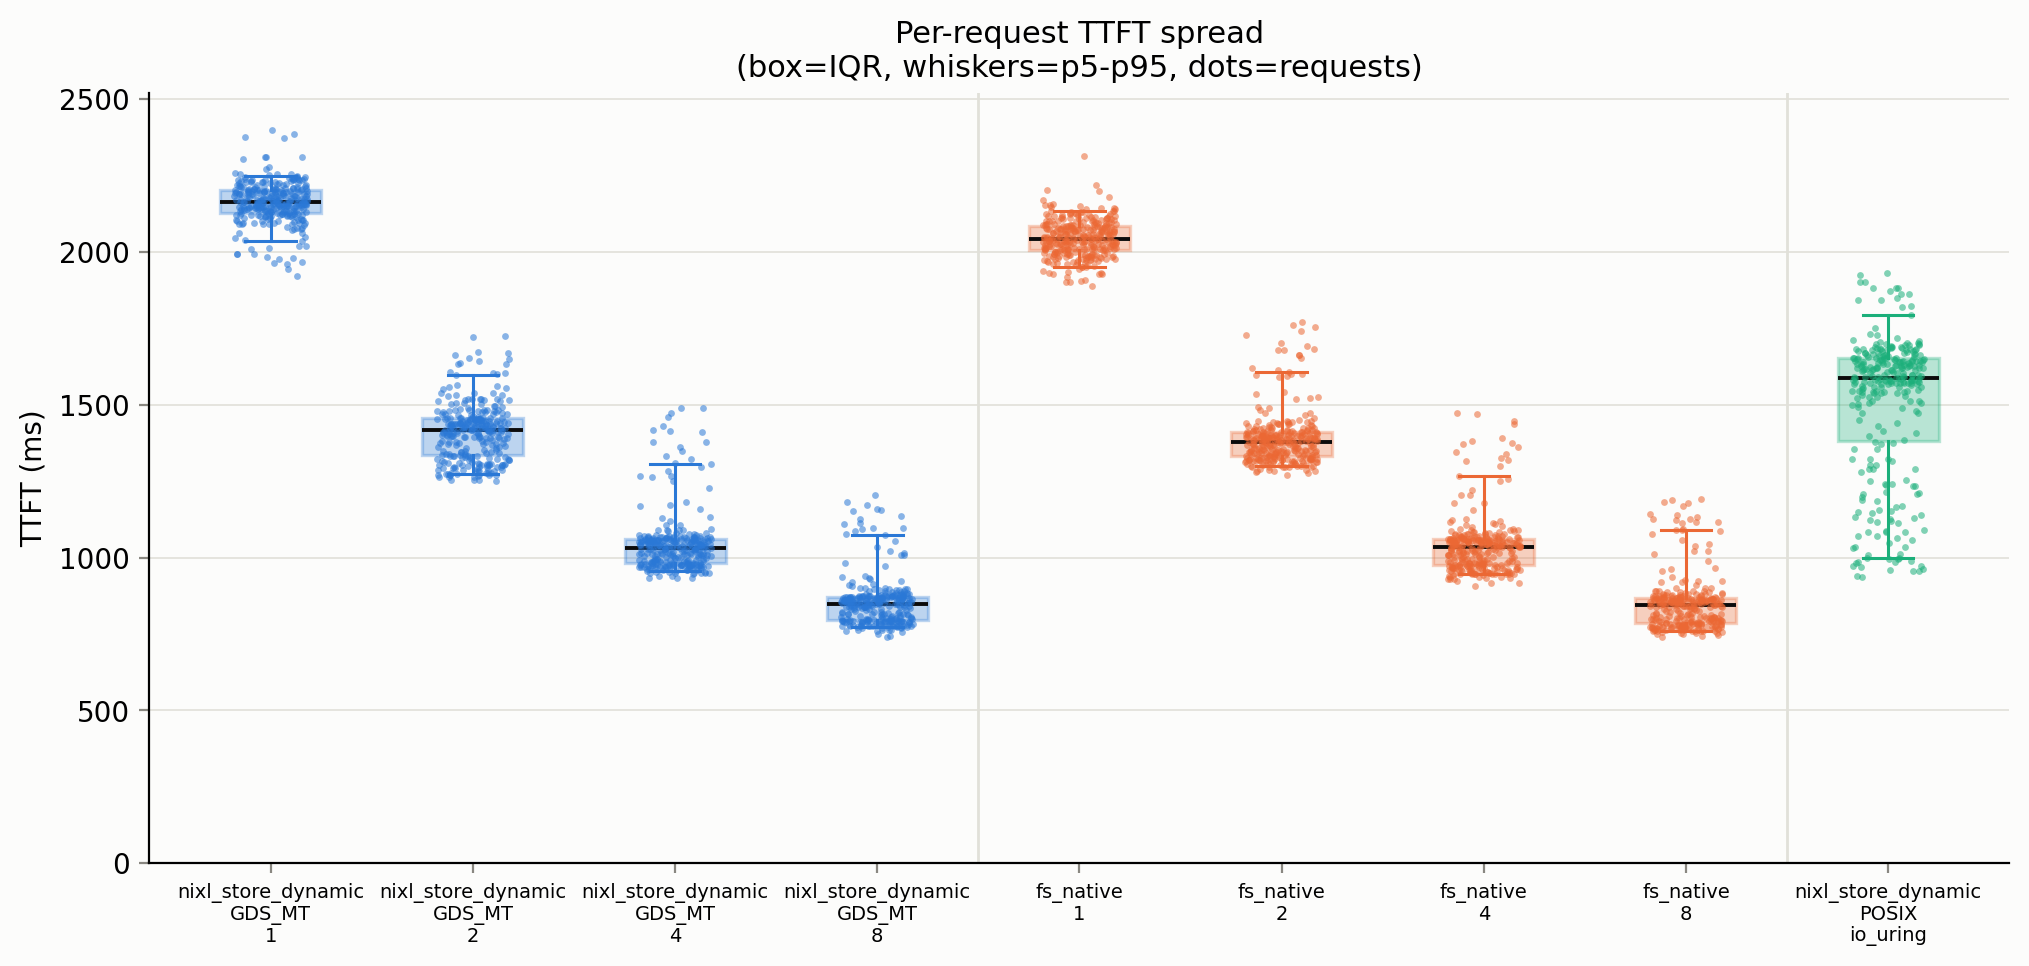
ここで疑問になるのは、なぜGDSをベースとした結果とPOSIXベースのデータ転送の性能がほぼ互角になるのか、ということです。これは、LMCacheを利用する場合のKV Cacheの階層的Offloadの仕組みによるものです。LMCacheの階層的Offloadは、下図のように各階層のOffloadで利用される技術が変化し、L1からL2に対してのOffloadは実質的にメインメモリーからStorage I/Oになります。
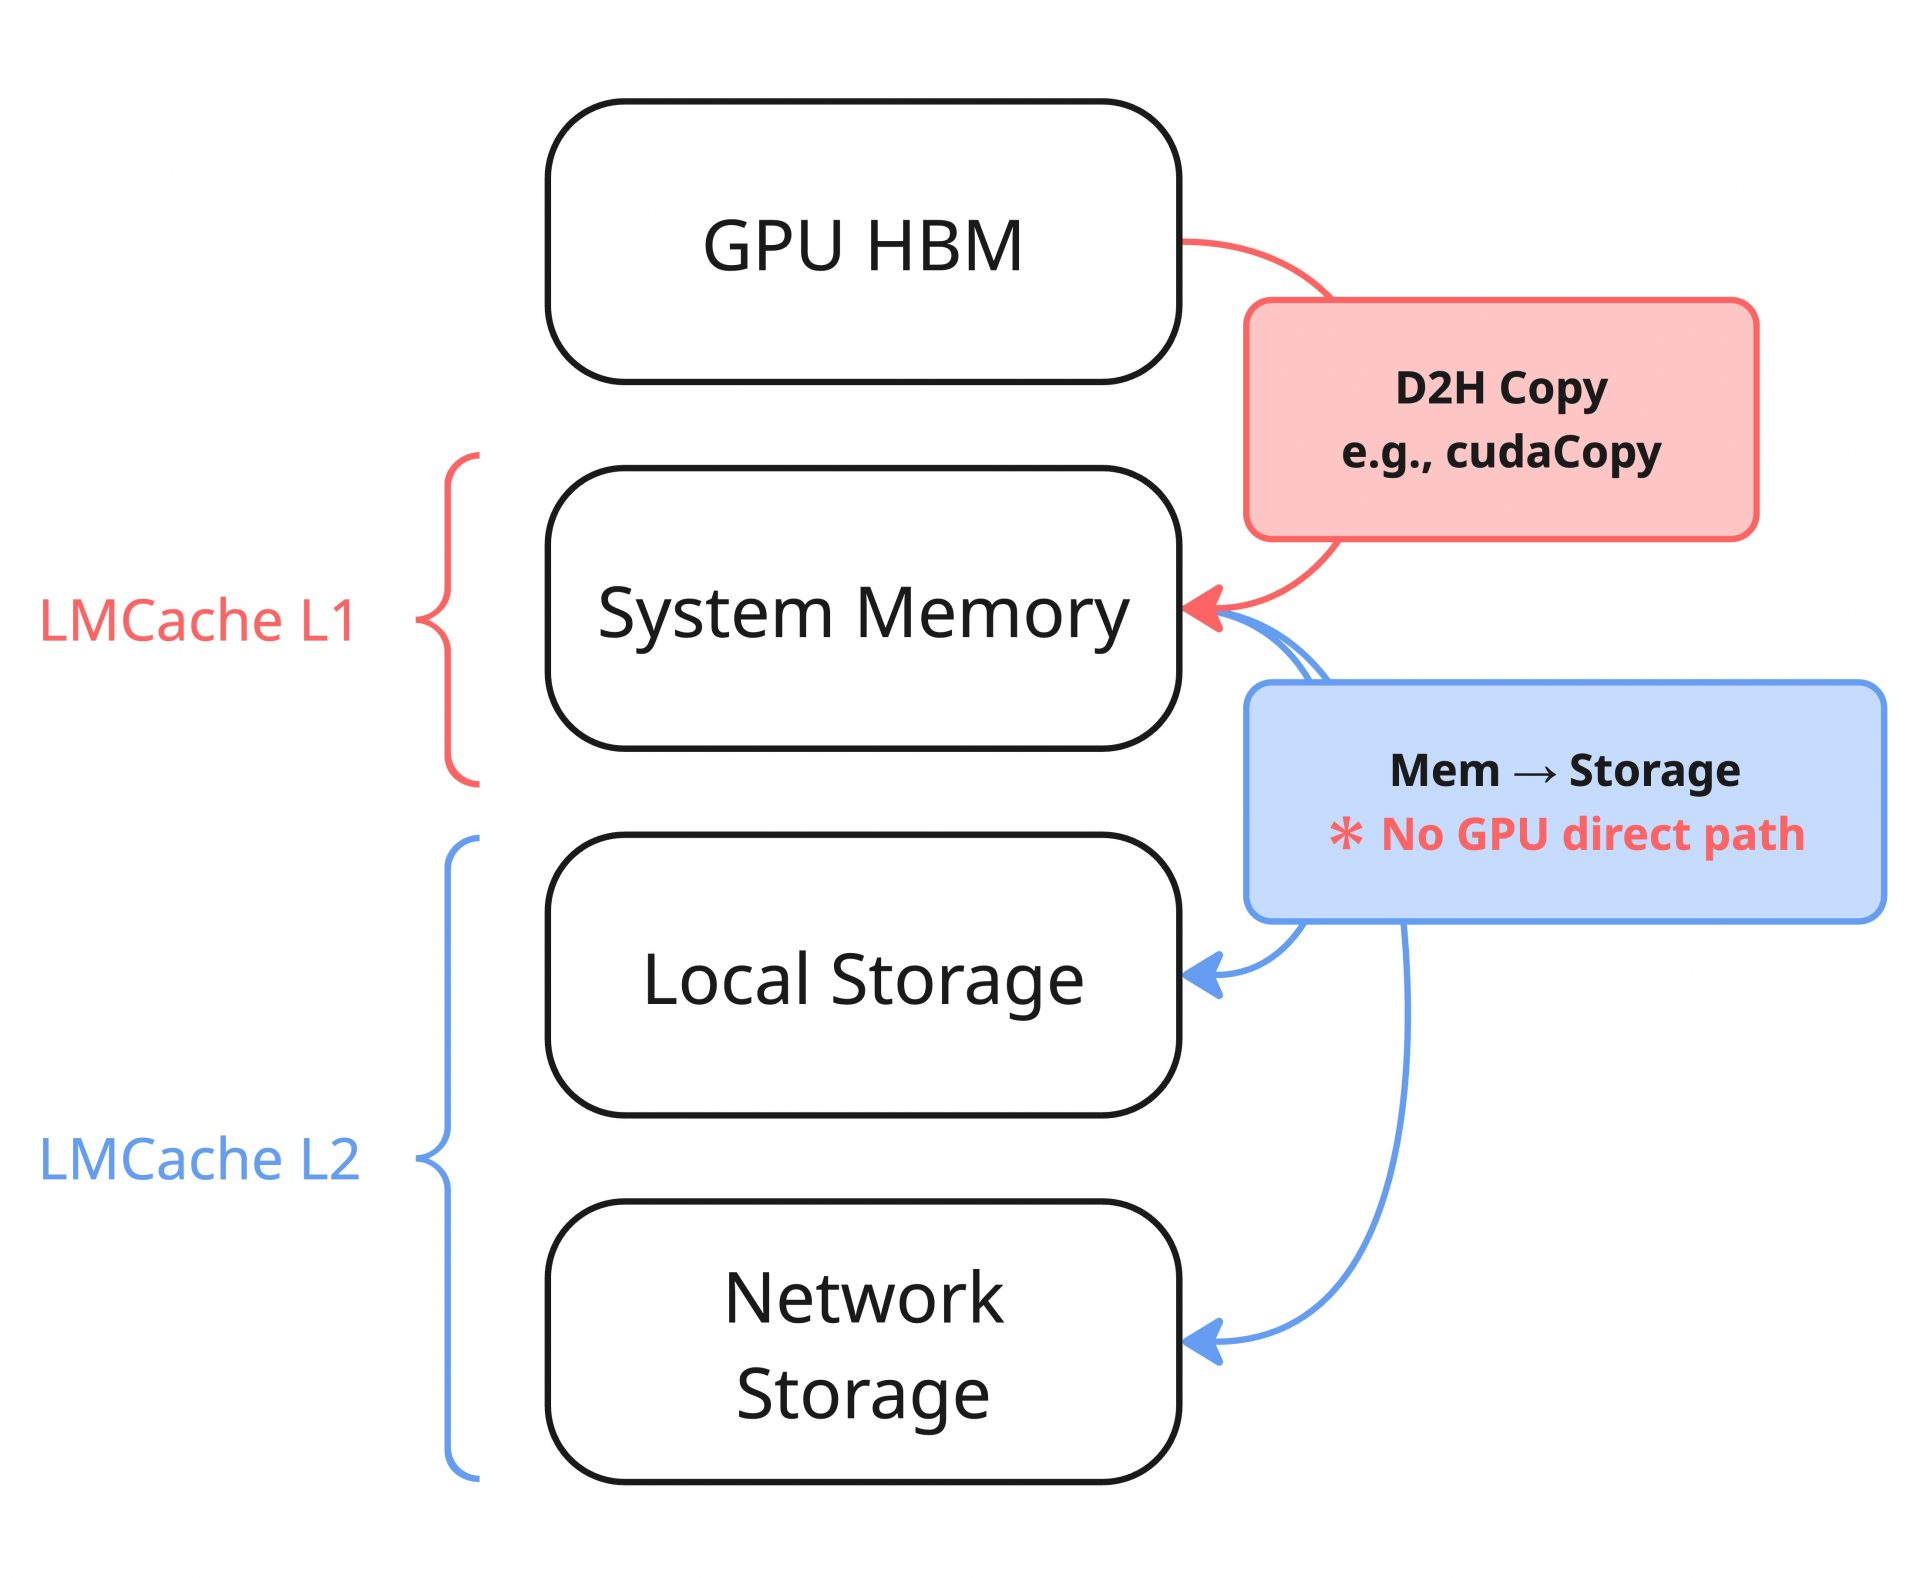
つまり、L1/L2を両方有効にした通常のLMCache階層では、L2はL1に保持されたデータをL2へWrite-Backする構造であり、GPUからStorageへの直接のI/Oではないため、そもそもGPUDirect Storageが最適化するデータ転送パスではないわけです。これはL2 AdapterとしてNIXL Agentの転送元がデフォルトでDRAMになっており、更にGDSとしてもこれをサポートしているため、NIXL + GDSという組み合わせでも自然に成立するデータパスになります。この転送経路においては、POSIXベースのI/Oと大きく遜色なく、特にfs_nativeの場合はDirect I/Oの条件も合わせているため、結果として同程度の性能になった、ということです。
さて、ここで一つ議論になるのは「推論基盤のKV Cacheの転送において、GPUDirect Storageは不要なのか?」という点です。少なくとも「KV Cacheを階層的に配置するケースにおいて、ソフトウェア実装次第では効果が薄い場合がある」とは言えるでしょう。ただし、補足情報として、LMCacheにはGDS L1 Tierという仕組みがあり、これはL1 Cache Tierをデフォルトのメインメモリーからストレージへ変更し、GDS経由でI/Oを最適化する方式のようです。この機能について今回試しておらず、近年のGPUサーバーのようにメインメモリーが比較的潤沢である環境においてどの程度メリットがあるかは計りかねますが、これであれば確かにKV Cacheの転送という文脈でGDSが有効に働くことになります。
また、KV Cacheという文脈から少し視点を広げて推論システムという観点でみると、例えば Dynamo ModelExpress を利用するケースが思い当たります。Dynamo ModelExpressは端的に言うと推論インスタンスのスケールアウト高速化のための仕組みですが、この中でLocal StorageからGPUにWeightを読み出す方式と、その方式においてGDSが利用できる旨が読み取れます。確かにこのケースであればGDSの効果が発揮できそうです。
GDSの効果を最大化するためにはサーバーレイアウトなどを考慮する必要がある旨を前述しましたが、最適化を狙う処理が本当にGPUとStorage間でデータ転送をする仕組みになっているかという、実装への理解がなければ意図した結果が得られないということになりかねません。今回の調査・検証を行っていく中で、KV Cacheの階層的Offloadの例はまさにそのようなものの一つでしょう。
おわりに
今回はKV Cacheの話を主軸としながら、Storageの議論やGPUDirect StorageのようなGPUとStorageの間のデータ転送を最適化する技術について詳細に説明した上で、実際に環境を構築し性能を測定してみました。KV Cache向けのストレージの必要性は、そのシステムが収容するワークロード負荷に依存するということは改めて伝えておきたいですが、実際に大きな負荷がかかる環境においてストレージが大きな効果を発揮するという一面が確認できました。ただ、これを実現するためにはストレージに対する深い理解も欠かせないことが少しでも伝われば幸いです。
これまでの連載の議論で、インフラレベルでの要点を押さえた議論を大雑把にではあるものの完了したと感じているため(もちろん細かい話はまだまだありますが)、次回以降の記事では、よりプロダクションデプロイメントを意識した技術について取り上げ、紹介していければと考えています。それらの議論を進めるなかでも、ここまでの連載の内容はほぼ必須の知識として活用していく想定ですので、もし興味があればぜひ引き続きお付き合いください。
コラム:G3.5 TierとContext Memory Storage
ご存知の方も多いかもしれませんが、最近は前述のTier図にG3.5という領域を定義し、Inference用のContext Memory Tierなどと呼称しています。このレイヤーはその名の通り、推論におけるContext Memory(KV Cache)向けのストレージ領域であり、Local SSDとRemote Storageの間を埋めるものになっています。
技術的には、オールフラッシュのリモートストレージと、RDMAベースのNVMe-oFやObject Storageの組み合わせによって実現される推論用途専用の共有ストレージという印象です。NVIDIAはこのG3.5 Tierを最適化する構成として、BlueField DPUを利用した構成を打ち出しており、本来ホストのCPUが行うストレージ関係のプロトコル処理などをBlueField上のCPUに委譲させる方針のようです。もし技術的に気になる方がいれば、DOCA SNAP Servicesあたりの資料を見てみると良いかもしれません。彼らの世界観は、NVIDIA CMX Context Memory Storage Platformと呼ばれています。
余談かつ自分が把握している範囲の話ですが、CES 2026の時点でNVIDIAからこのコンセプトをICMS(Inference Context Memory Storage)という名称で打ち出されましたが、GTC 2026あたりでは現在のCMXに改名されていました。
個人的に、ICMSの情報が登場したころからストレージベンダーの動向を気にしていたのですが、初期段階で対応表明だけでなく、既存の自社アーキテクチャをどう変えて実現するかまでを具体的に示したストレージベンダーの一社がVAST Data社でした。端的に説明すると、VASTのCNodeの機能をBlueField側で動作させ、DNodeとNVMe-oFで接続する構成です。これはVASTのDASE ArchitectureにおけるCNodeとDNode間の接続がNVMe-oFであるため、CBoxをGPUサーバー(BlueField)まで持ち込むことで期待するような構成になるという、元々のアーキテクチャとG3.5 Tierコンセプトとの相性の良さに起因する部分も大きかったのではないかと推察しています。詳細に興味がある方は公式ブログを参照してください。あくまで当時のコンセプトであるため、実際に製品として登場した場合にどうなるかは未知数ではありますが、個人的には実際の実装がどのようになるか気になるところです。
今後、この流れに対してストレージベンダー各社がどのように対応してくるのかを、そのコストやソリューションが必要となる規模感なども現実問題として加味しつつ、推論基盤の視点からキャッチアップを継続していく予定です。